GPT-Image 2.5 实测:普通人最容易上手,效果最好的生图模型
OpenAI 突然发布了 GPT-Image 2.5。
官方一上来就给了几个很猛的升级:生成延迟最高降低 50%,局部编辑更准,连续修改不容易把前面的细节弄丢,还加入了 Sketch 手绘、图片批注和模板。OpenAI 同时公布,ChatGPT Images 与 API 图像模型每周已经生成超过 30 亿张图片。
看完发布页,我第一反应是:以前生图最难受的几个问题,它解决了吗?连续修改之后发生漂移是否解决?生图速度是否提升?修改指令是否可以准确完成?
那就来看看,这次 GPT-Image 2.5 到底怎么个事。
我先从连续修改开始测:在 ChatGPT 里生成一张桌面基准图,再围绕同一张图连改 4 轮,依次把杯子改黑、删掉中间一张便签、加一把茶匙,再把多肉换成花瓶。随后又画了一张很粗的书房草图,拿中文信息图只改一个数字,导出透明背景商品图,再从 Poster 模板走完整个生成流程。
这篇会先讲清楚 2.5 相比上一代升级了什么,再拆开 Flare 和 Sunburst 的区别,最后把几组实测过程和原图放出来。先不急着下结论,我们直接看测试。
一、这次有两款新模型:Flare 和 Sunburst
OpenAI 这次发布了两款新模型:GPT-Image-2.5 Flare 和 GPT-Image-2.5 Sunburst。官方给它们的定位很清楚:
- Flare:速度更快,主打日常高质量生图。适合社媒配图、批量出图和快速做方案。
- Sunburst:能力更强,主打生成和精细编辑。适合商品图、广告成片,以及需要反复修改的任务。
这里要分清网页端和 API。在 ChatGPT 网页版的图片功能里,不需要、也看不到让你手动选择 Flare 或 Sunburst 的开关。当前界面只提供质量档等选项,具体调用由 ChatGPT 自动处理;本文后面的网页实测也统一标为 ChatGPT Images 2.5,不把某一张结果硬归到其中一款模型。
如果通过 API 调用,才需要在两个模型之间做选择:追求速度、批量出图和日常配图,可以先用 Flare;更看重复杂生成、局部修改和多轮编辑精度,再选 Sunburst。两款模型的官方 token 单价相同,差别主要在速度和处理复杂任务的能力。
二、这次升级,我会把它拆成 4 件事
OpenAI 公布的数据很夸张:ChatGPT Images 与 API 图像模型每周合计生成超过 30 亿张图片。在这个体量上,2.5 把延迟、编辑和输入方式一起动了。
1. 更快:相对 Images 2.0,生成延迟最高降低 50%
这是官方的上限数据,不等于每张图都会快一倍。尺寸、质量档、地区、服务器负载和是否编辑图片,都会影响等待时间。
本文暂时不拿网页端等待时间做速度结论。没有逐轮计时,也无法排除网络和排队影响,所以这里只保留官方公布的「最高降低 50%」。
2. 更稳:让没被点名的内容少动一点
图像编辑最烦的地方,一直是改文字,改背景,改人脸,改小细节。2.5 的重点之一,就是在修改单个物体、背景或文字时,尽量保住主体、构图和品牌视觉。
官方还专门强调了多轮编辑:后一轮应该沿用前几轮的修改,减少越改越糊、越改越偏。我的桌面测试基本验证了这项能力,但也发现画面仍会发生轻微全局重绘,后面会展开。
3. 更像设计工具:草图、批注、模板、Prompt 分享
ChatGPT 新增了几个更接近设计工具的入口:
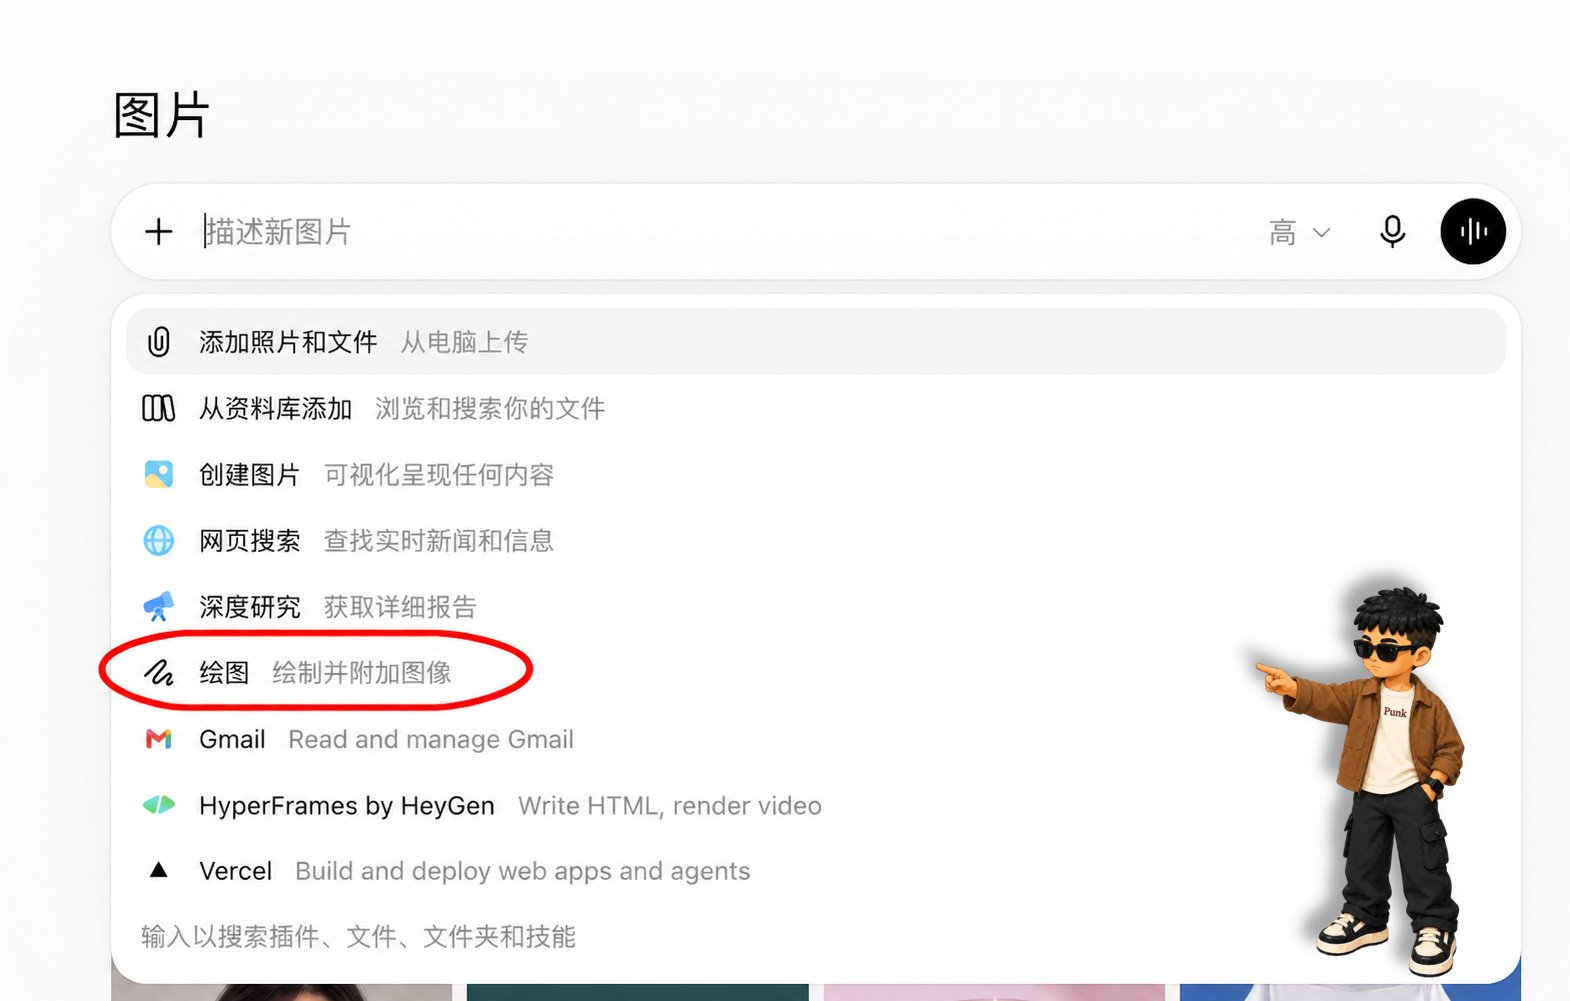
- 点击输入框左侧的 +,选择「绘图」,打开草图编辑器,再让模型按布局生成图片;
- 从图片卡片的「编辑」入口继续修改;官方还提到图片批注,可在指定位置告诉模型「改这里」;
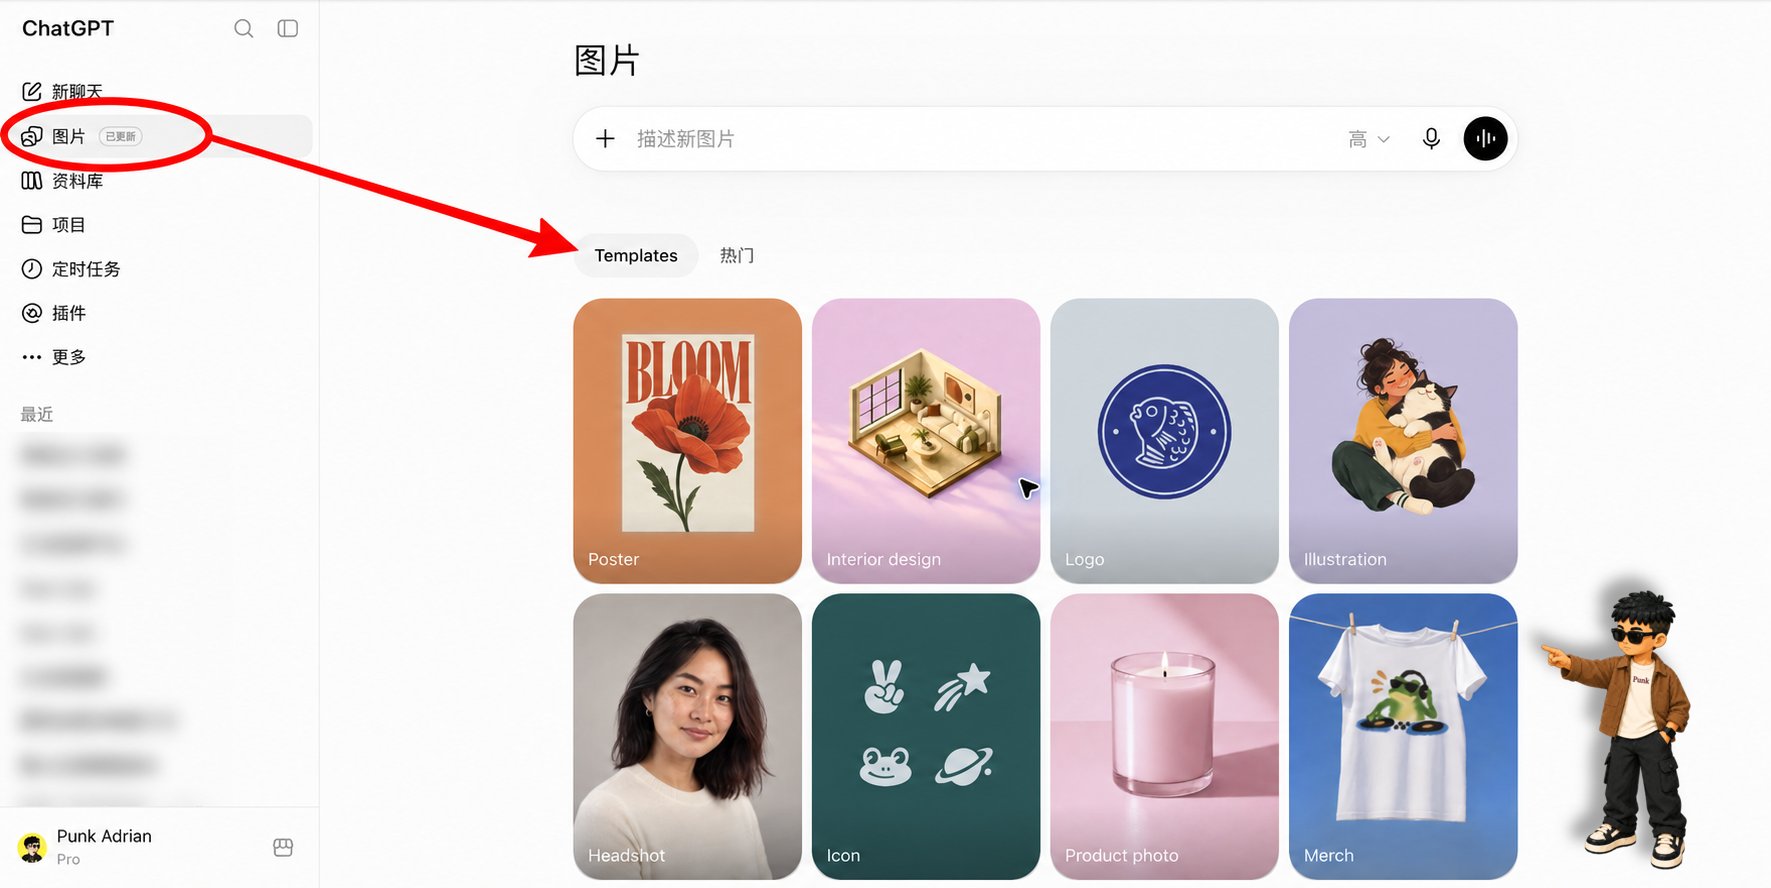
- 进入左侧「图片」,在 Templates 中选择 Poster、Merch 等模板,不必每次从空白提示词开始;
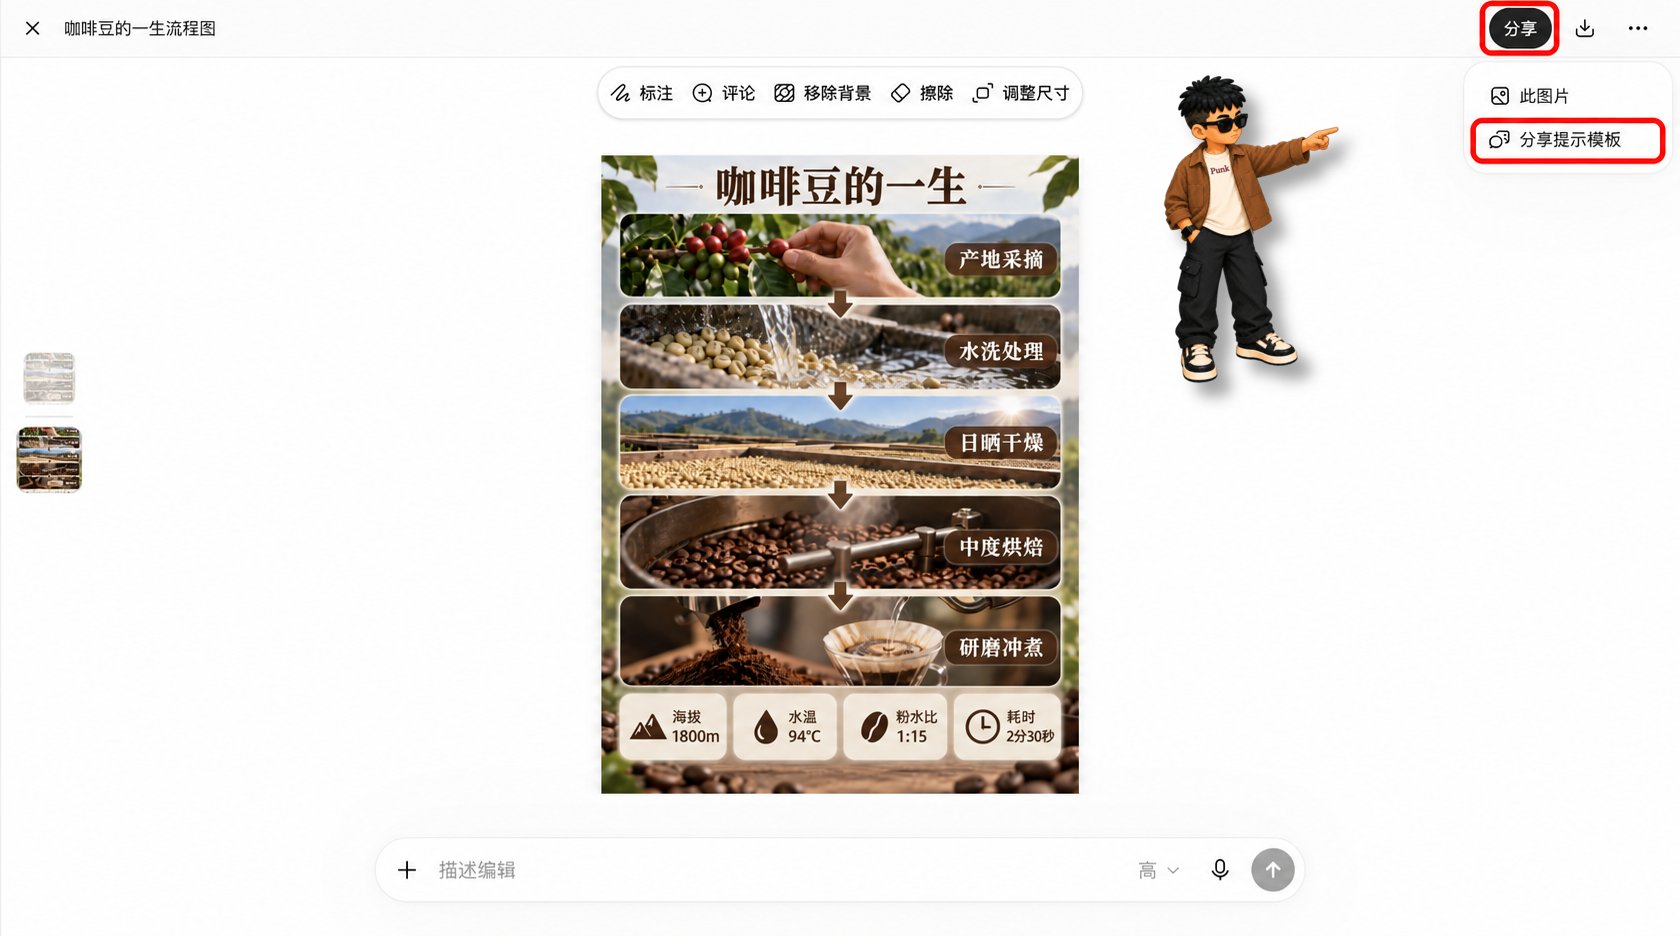
- 在编辑页右上角打开「分享」,可以单独分享图片,也可以选择「分享提示模板」。
模板入口在左侧「图片·已更新」中,点进去就能看到 Templates:
草图入口没有单独摆在页面上。点击输入框左侧的 +,在展开菜单中选择「绘图 / 绘制并附加图像」:
4. 画面能力:细节、光线、参考图和复杂布局一起提升
官方列出的升级还包括更自然的光照与纹理、更强的参考人物保真、更准确的现实信息,以及对透明背景和复杂布局的支持。系统卡又补了一项:信息图的准确性和排版也有改善。
三、实测一:复杂桌面连续改四轮,前面的修改没有丢
下面 5 张生成图和 1 张输入截图都来自 2026 年 9 月 9 日 ChatGPT 网页端的同一个对话,基准图和四轮修改均由用户手动提交。ChatGPT 当前使用 Images 2.5,但不会显示每张图具体调用 Flare 还是 Sunburst,因此这里只写 ChatGPT Images 2.5 实测。
初始图:7 组物件与空间关系全部到位
实际提交的提示词:
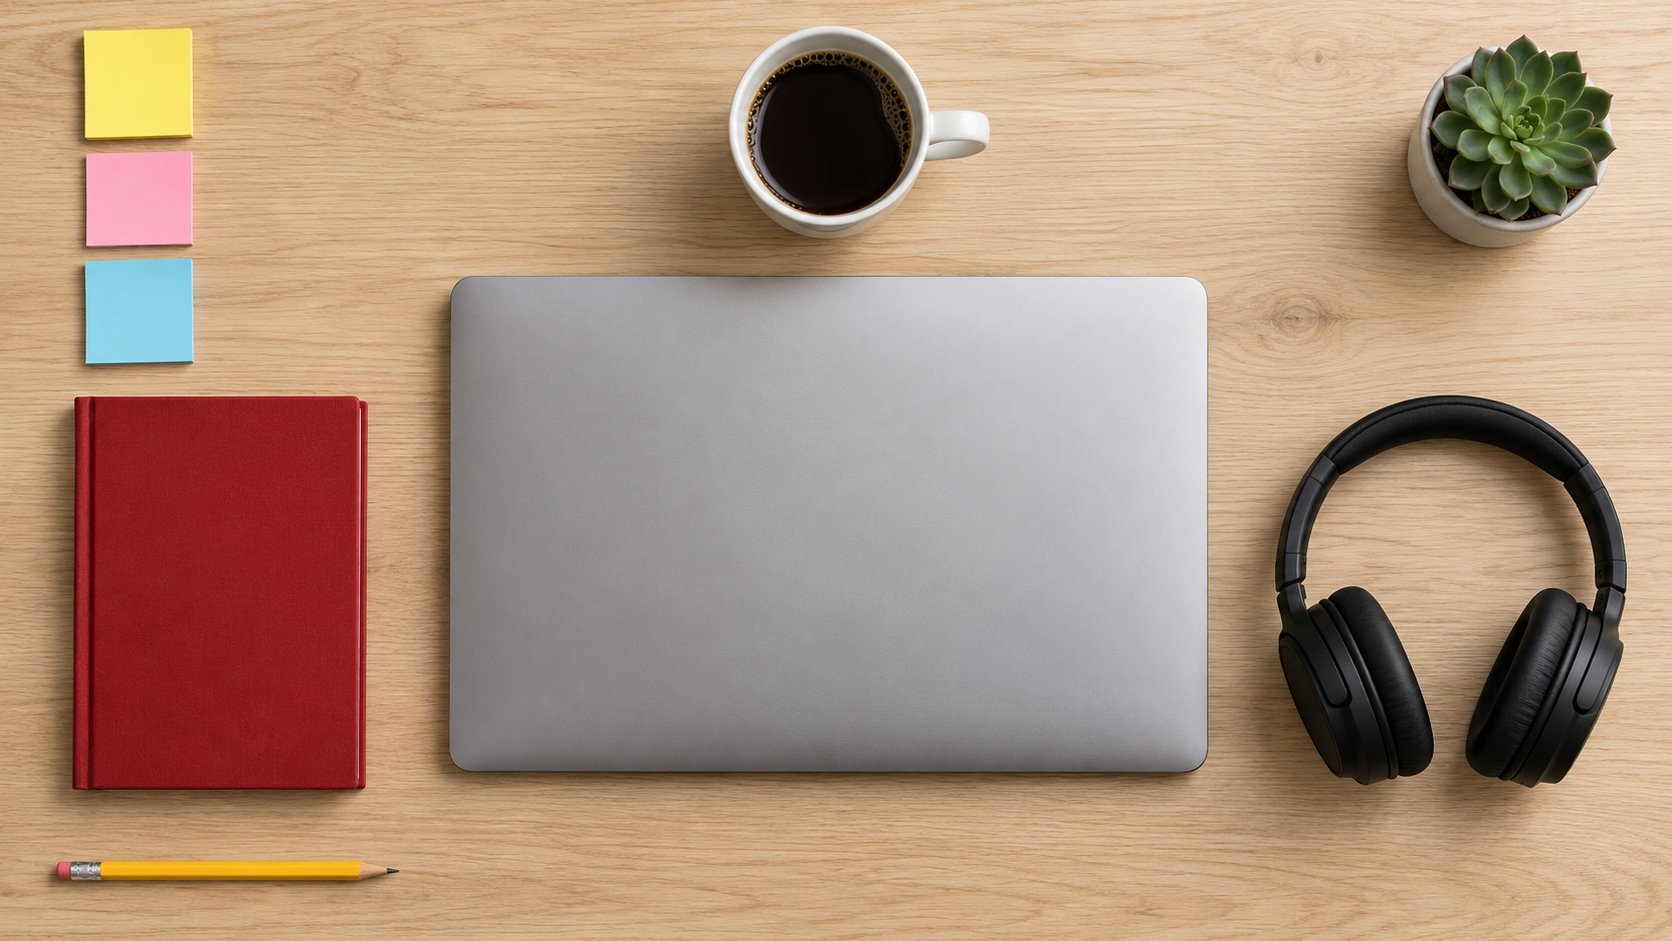
第一轮:只把白色杯子改成哑光黑
实际提交的提示词:
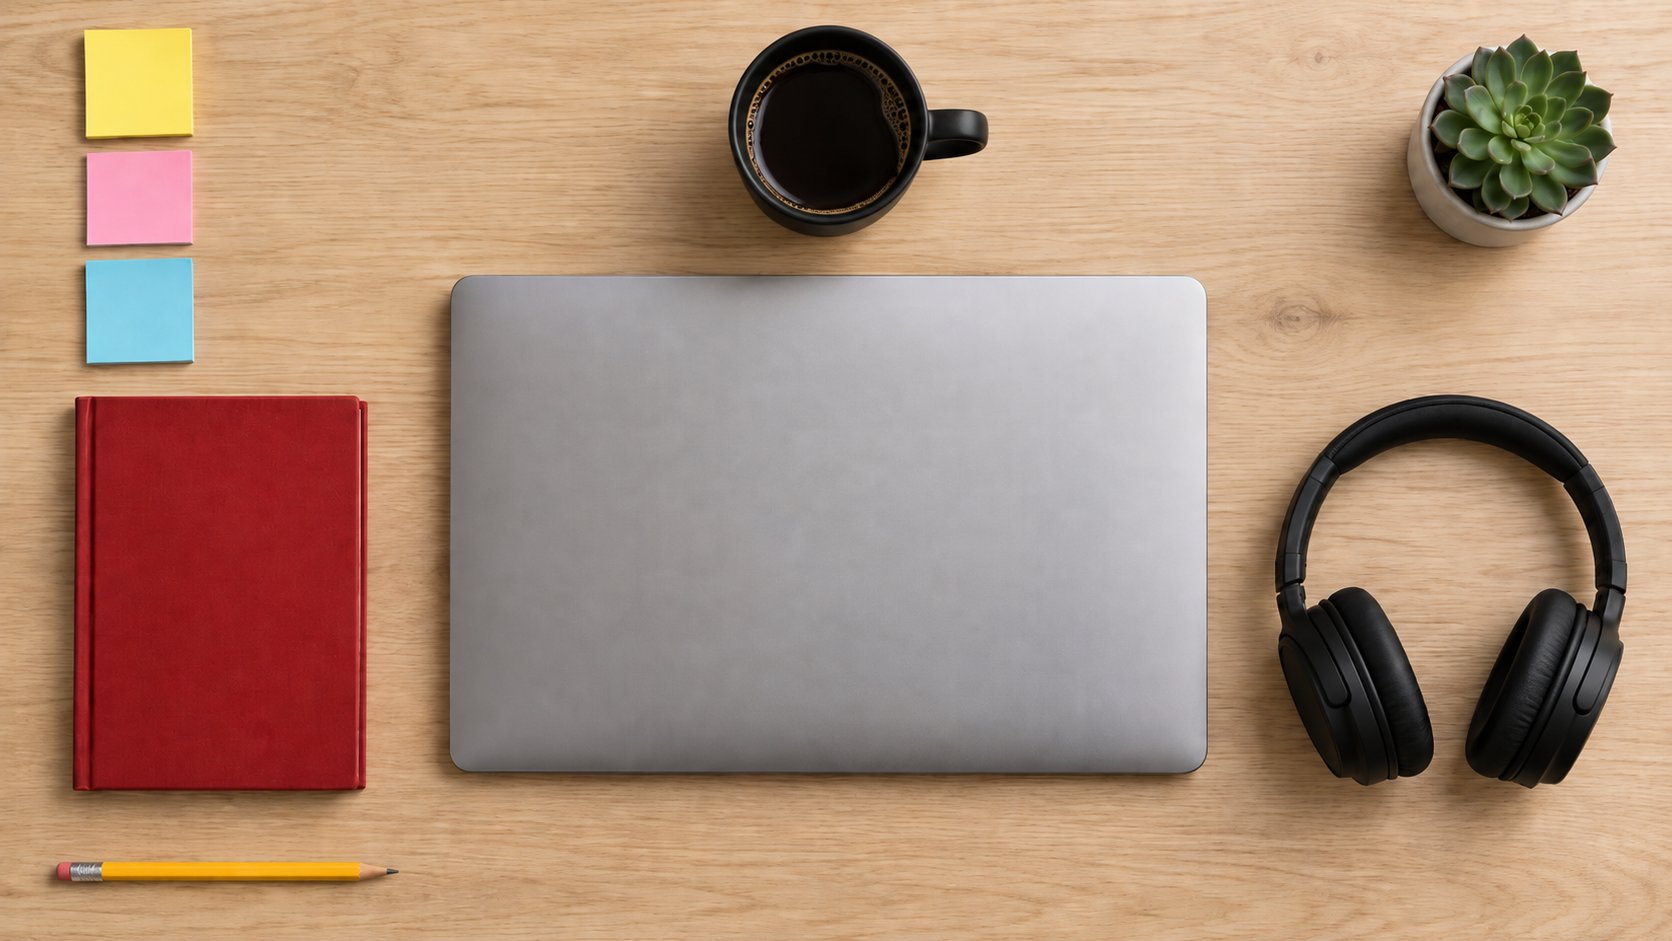
杯子准确变成黑色磨砂材质,位置、朝向和咖啡液面都保住了。电脑、便签、红色笔记本、耳机、铅笔和多肉没有明显移动,但桌面纹理与物体表面仍有轻微重绘。
第二轮:只删中间一张便签,上下两张不挪
实际提交的提示词:
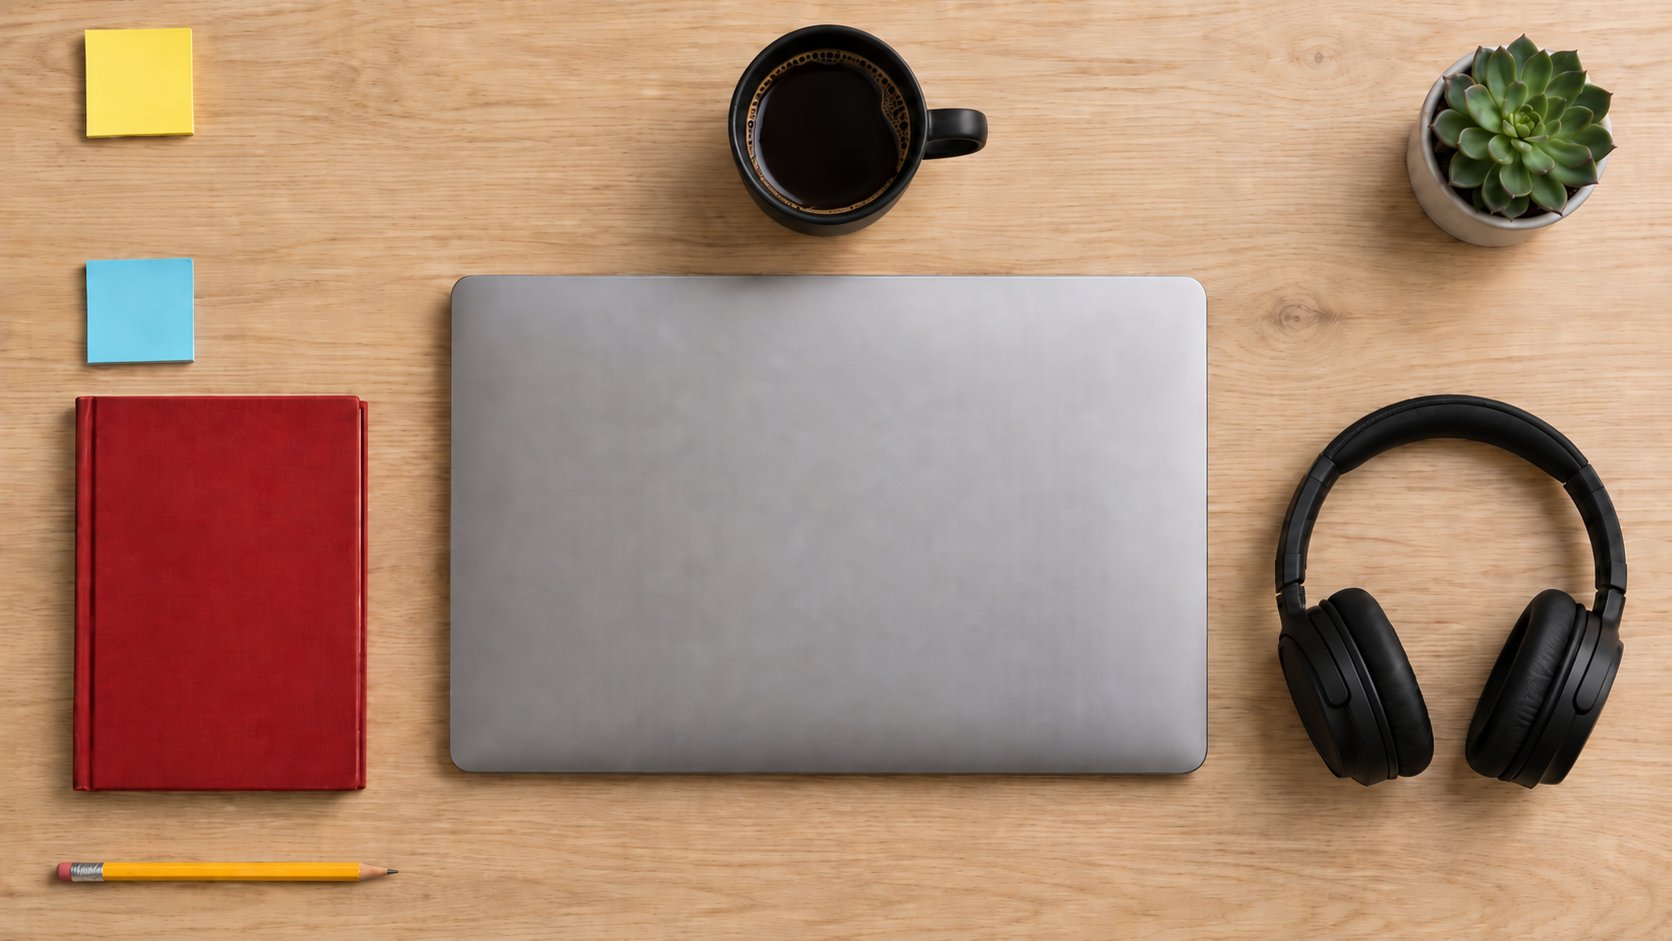
这一轮最考验位置理解。模型准确删掉了中间便签,上下两张没有自动合拢;上一轮的黑色杯子也保留了。
第三轮:在黑色杯子右边加一把竖直茶匙
实际提交的提示词:
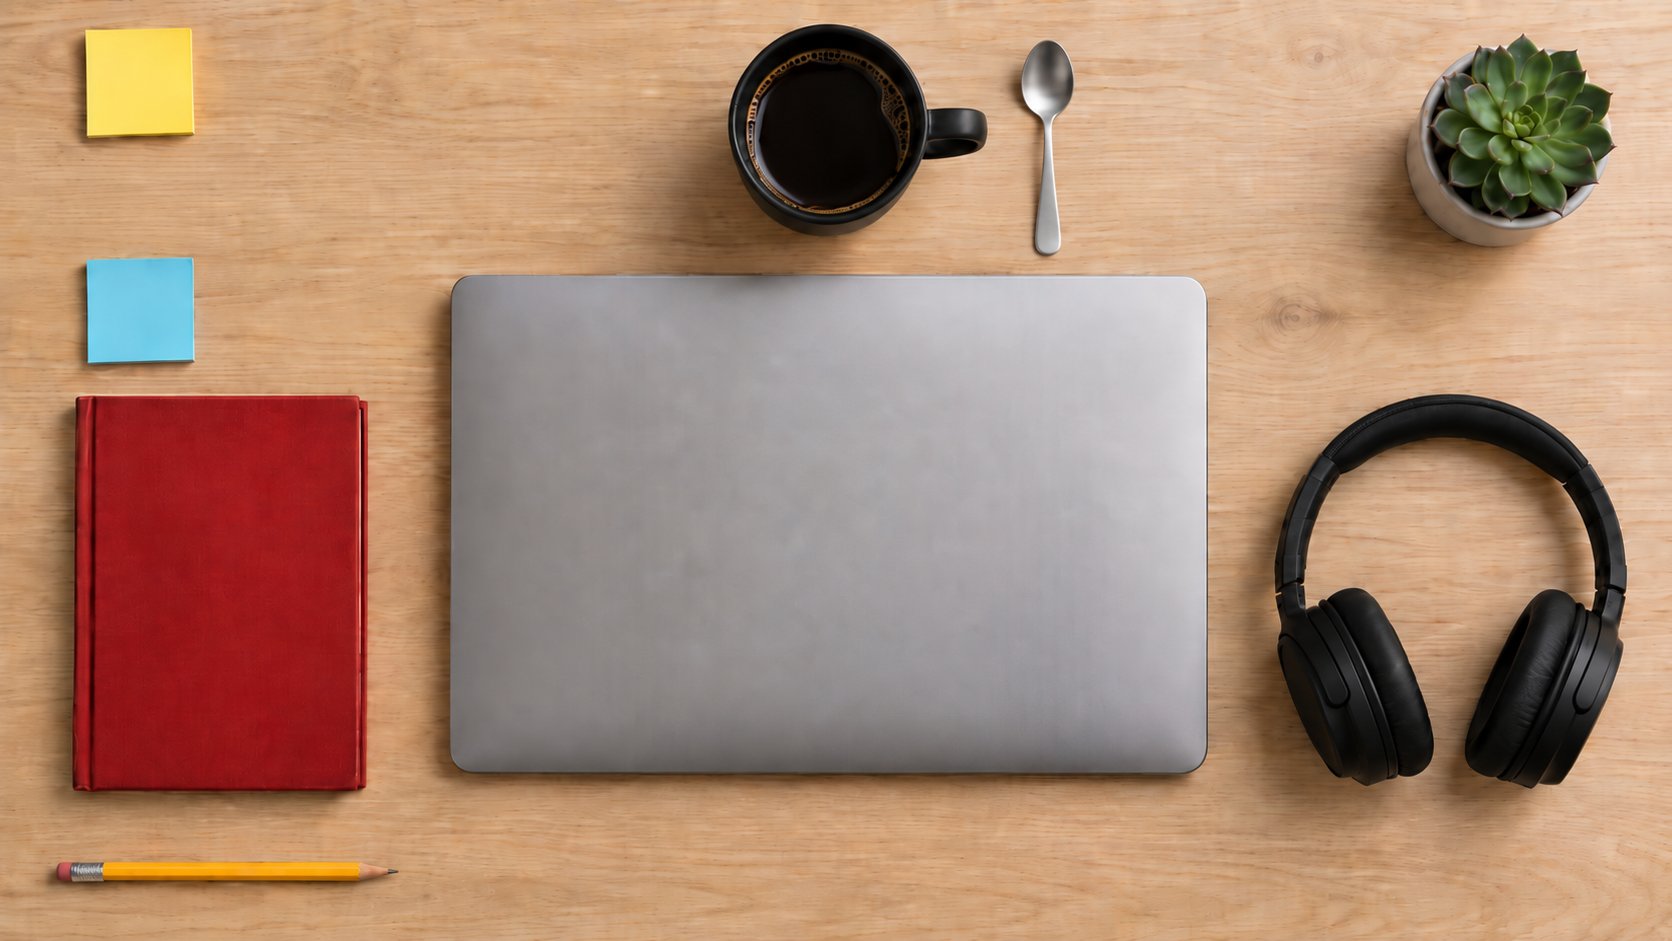
茶匙被放在黑色杯子右侧,方向与电脑右边缘平行,比例和阴影也合理。前两轮的黑杯与便签缺口继续存在,电脑、耳机、笔记本、铅笔和多肉仍然保持原来的构图。
第四轮:在第三张图的基础上,把右上角多肉换成三枝白色郁金香
这次测试,主要想测试之前的问题是否被解决。以前,如果你想改之前版本,基本上无法修改。
这次提交时,画面保留第三轮的黑杯、便签缺口和银色茶匙,并在编辑输入框中明确要求只替换多肉:
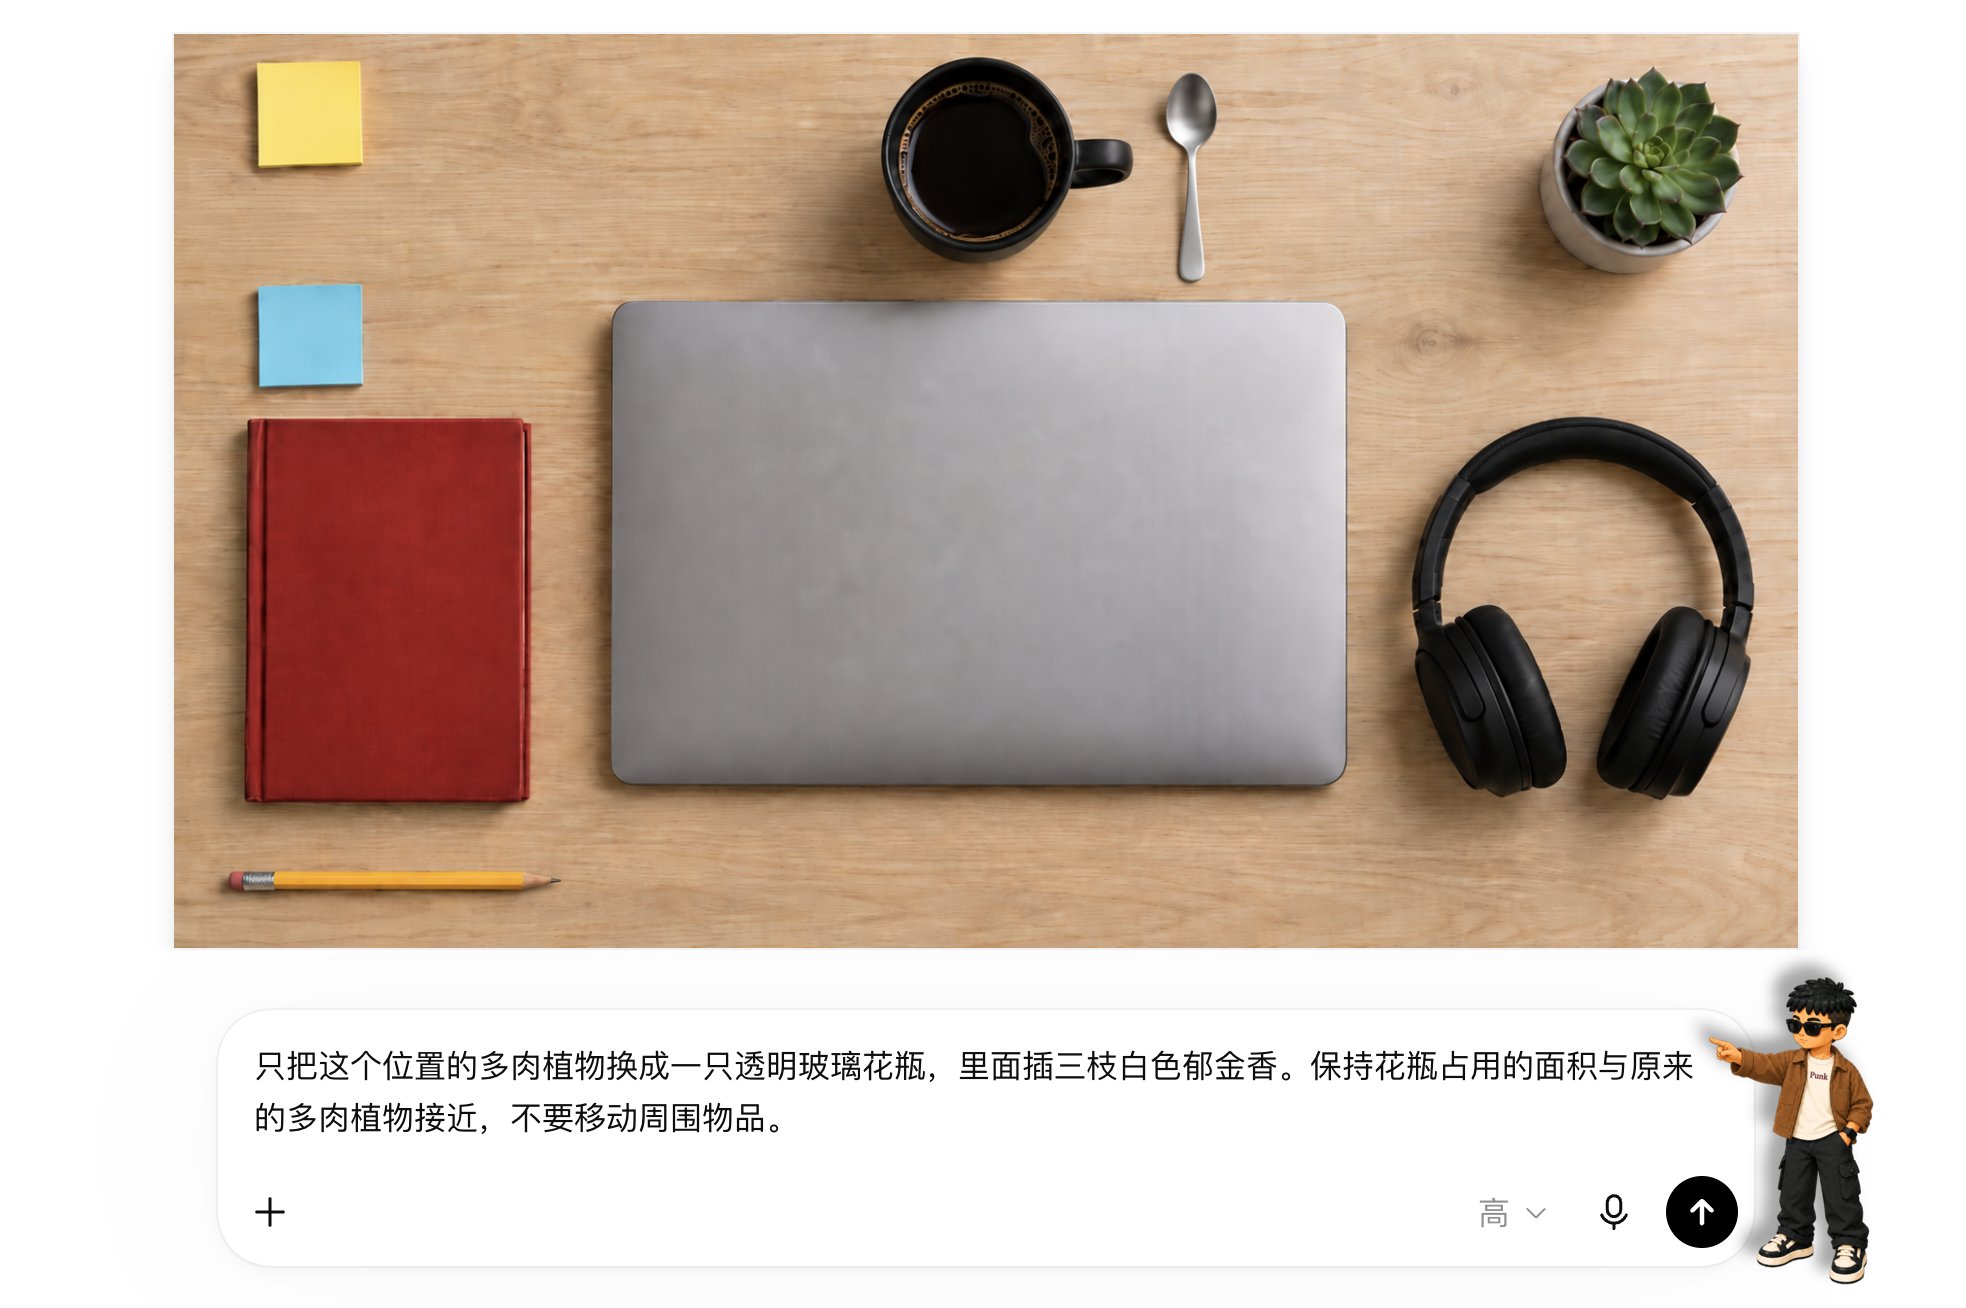
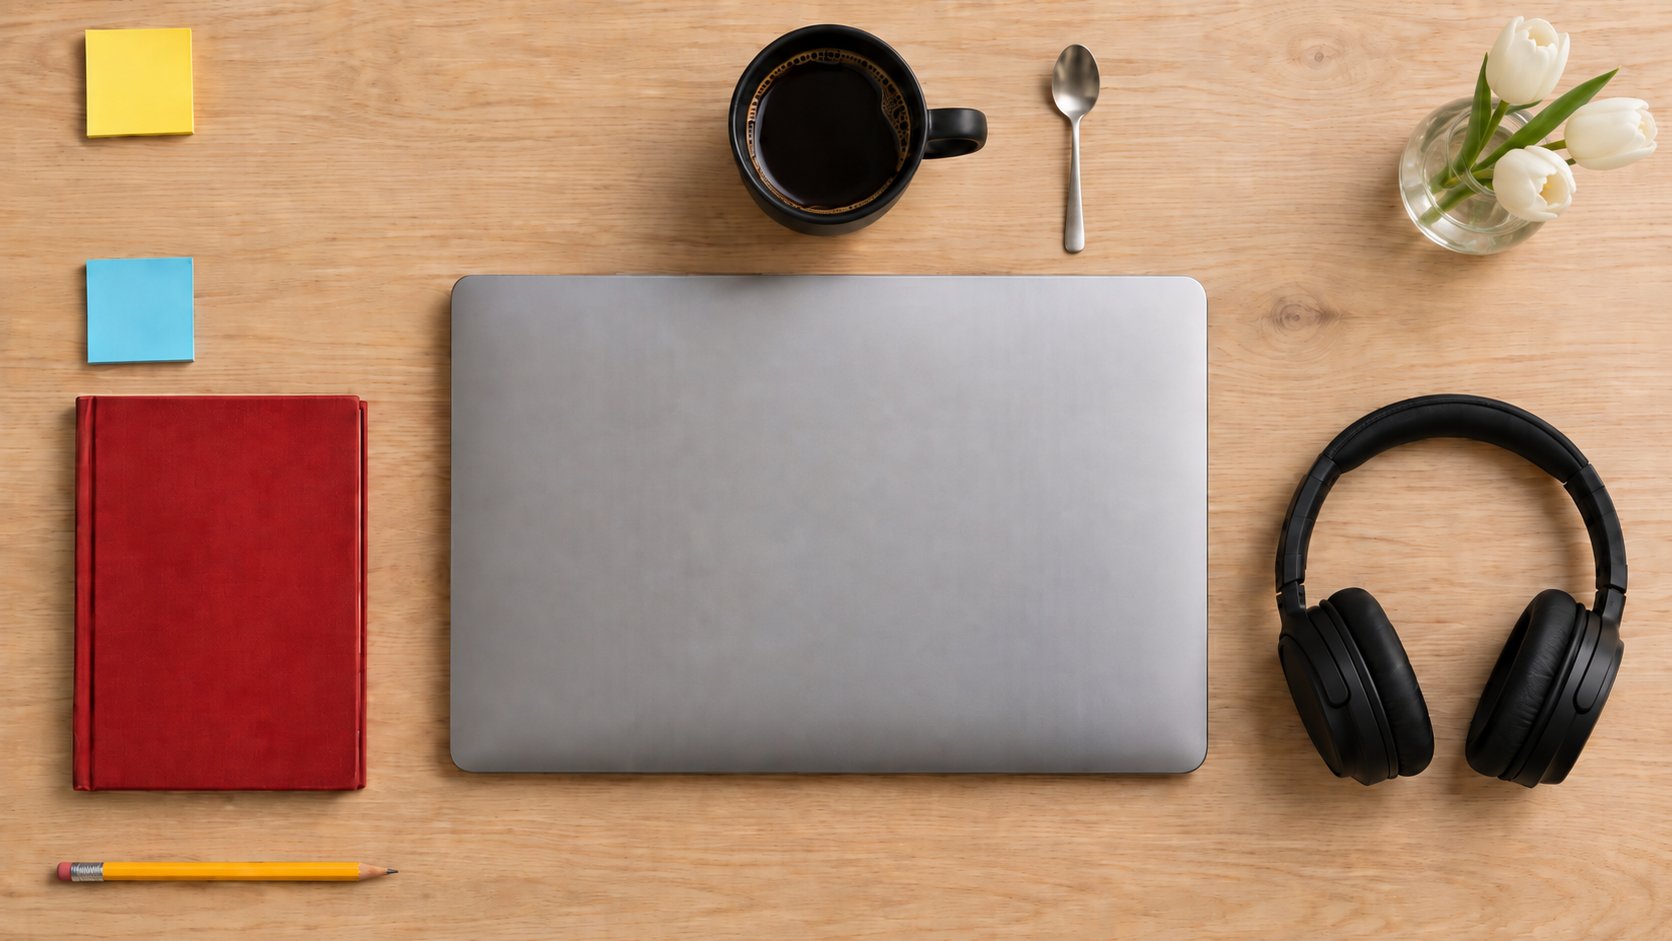
多肉被换成透明玻璃花瓶,里面有三枝白色郁金香,占用面积与原花盆接近,其他物件的位置也没有明显漂移。
我抽查了四轮里没有要求修改的区域,相邻图片的结构相似度约为 0.87—0.99。它保住了物件和构图,同时仍会重绘部分纹理。这组结果支持「可以围绕一张图连续工作」,并不代表未选中的像素完全不动。
如果每轮只改一件事,并重复关键约束,ChatGPT Images 2.5 已经能跑通「先出第一版,再小步精修」的流程。像素级商品合成、Logo 保护和严格品牌色仍要回到设计软件验收。
四、实测二:导出的 PNG,背景是否真的透明
透明背景最容易被预览界面骗到:看起来像棋盘格,不代表文件里一定有 Alpha 通道。这张摩卡壶来自 ChatGPT Images 2.5,下载得到的是一张 1254×1254 的 PNG。
实际提交的提示词:
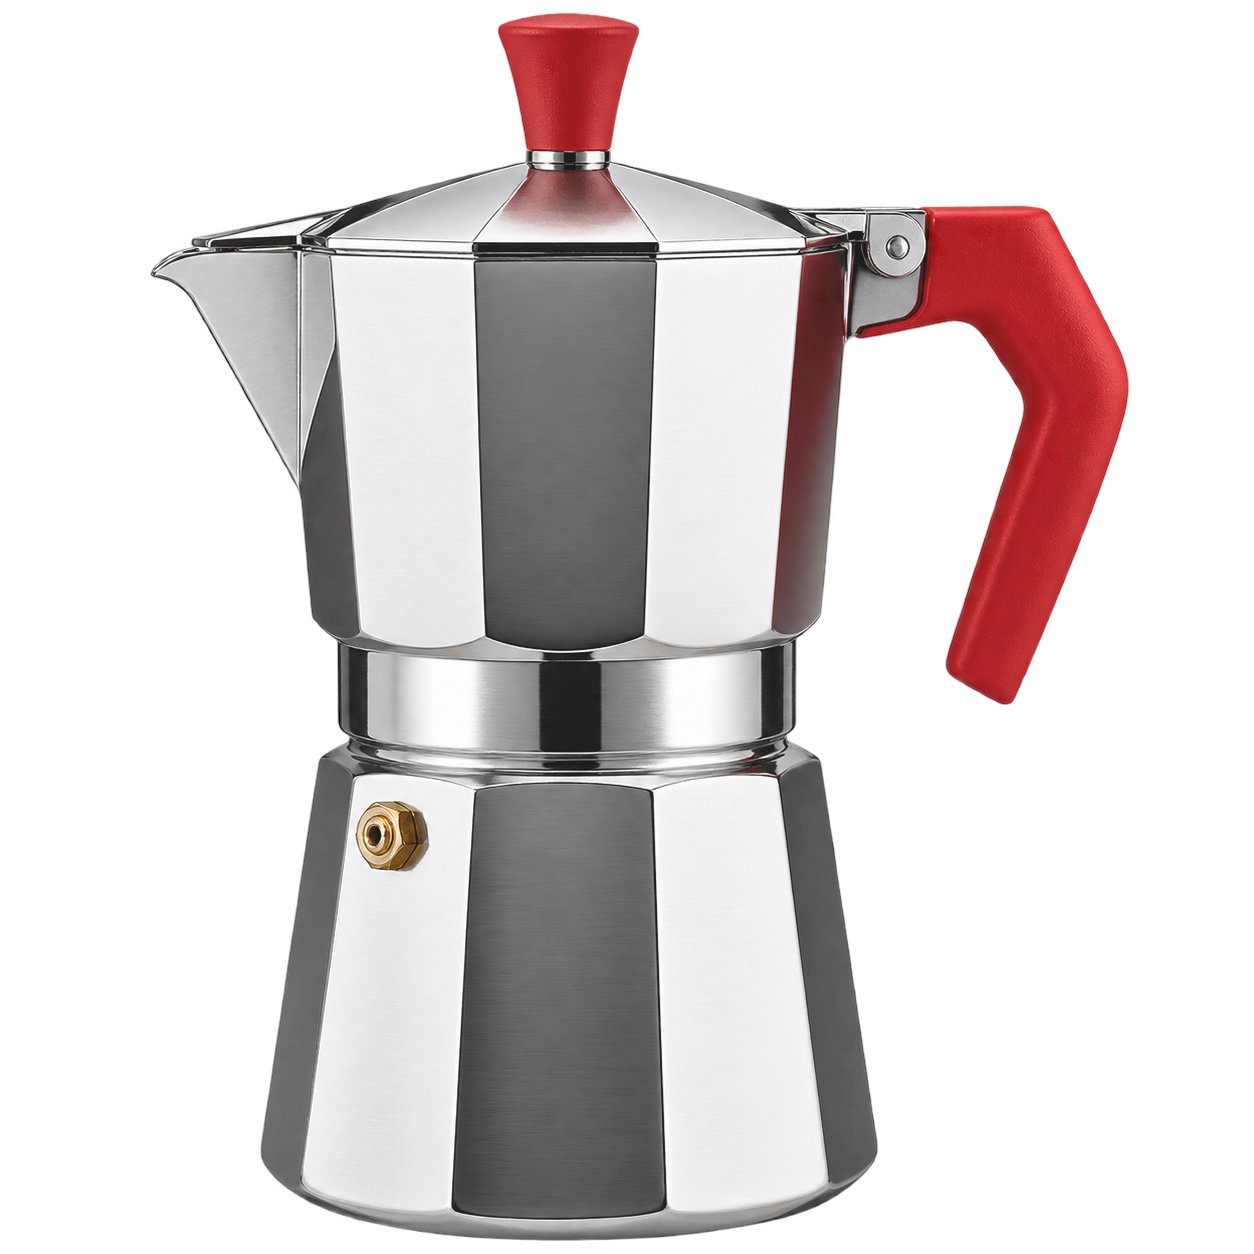
我直接检查了原文件。它使用 sRGBA 四通道,文件并非全不透明,四个角的 Alpha 值均为 0;也就是说,预览里的黑色或白色来自查看器,背景确实已经被移除。
我又把同一张原图放在棋盘背景上检查,没有修补或重新生成摩卡壶:
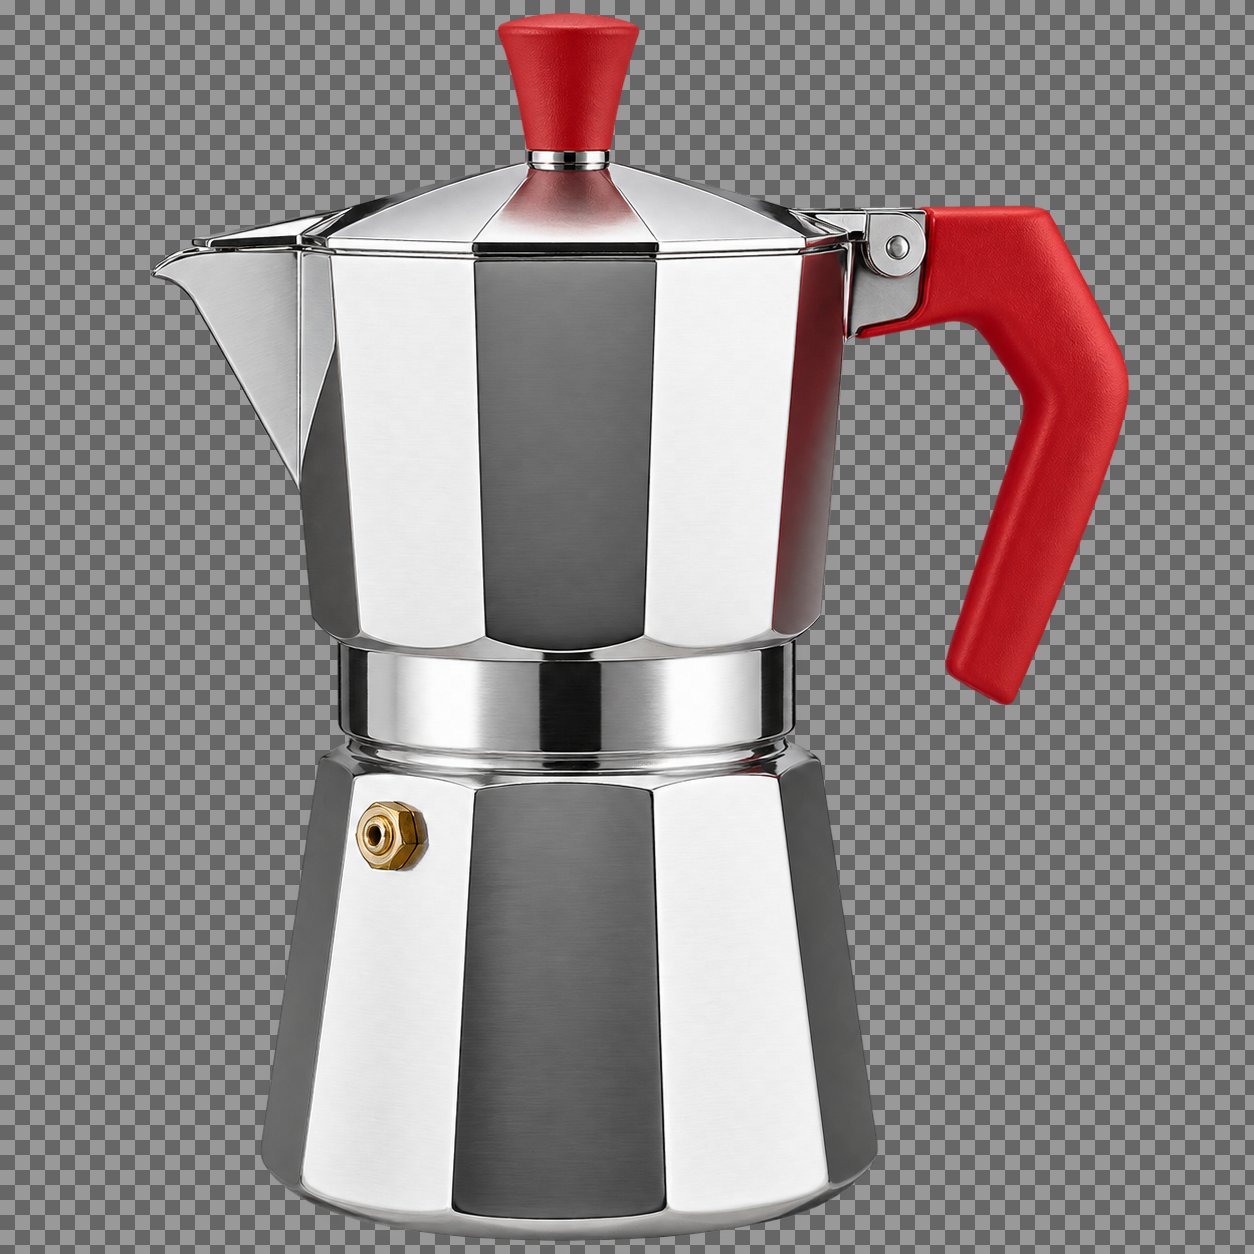
外轮廓整体干净,没有发现明显白边、黑边或残留背景。
这张测试图通过了透明通道和边缘检查,可以直接作为透明背景素材继续使用。电商主图和正式商品素材仍建议放到棋盘格、纯黑和纯白三个背景上走一遍验收,避免在单一预览底色下漏掉细小问题。
五、实测三:一张随手草图,能不能变成可用的室内效果图
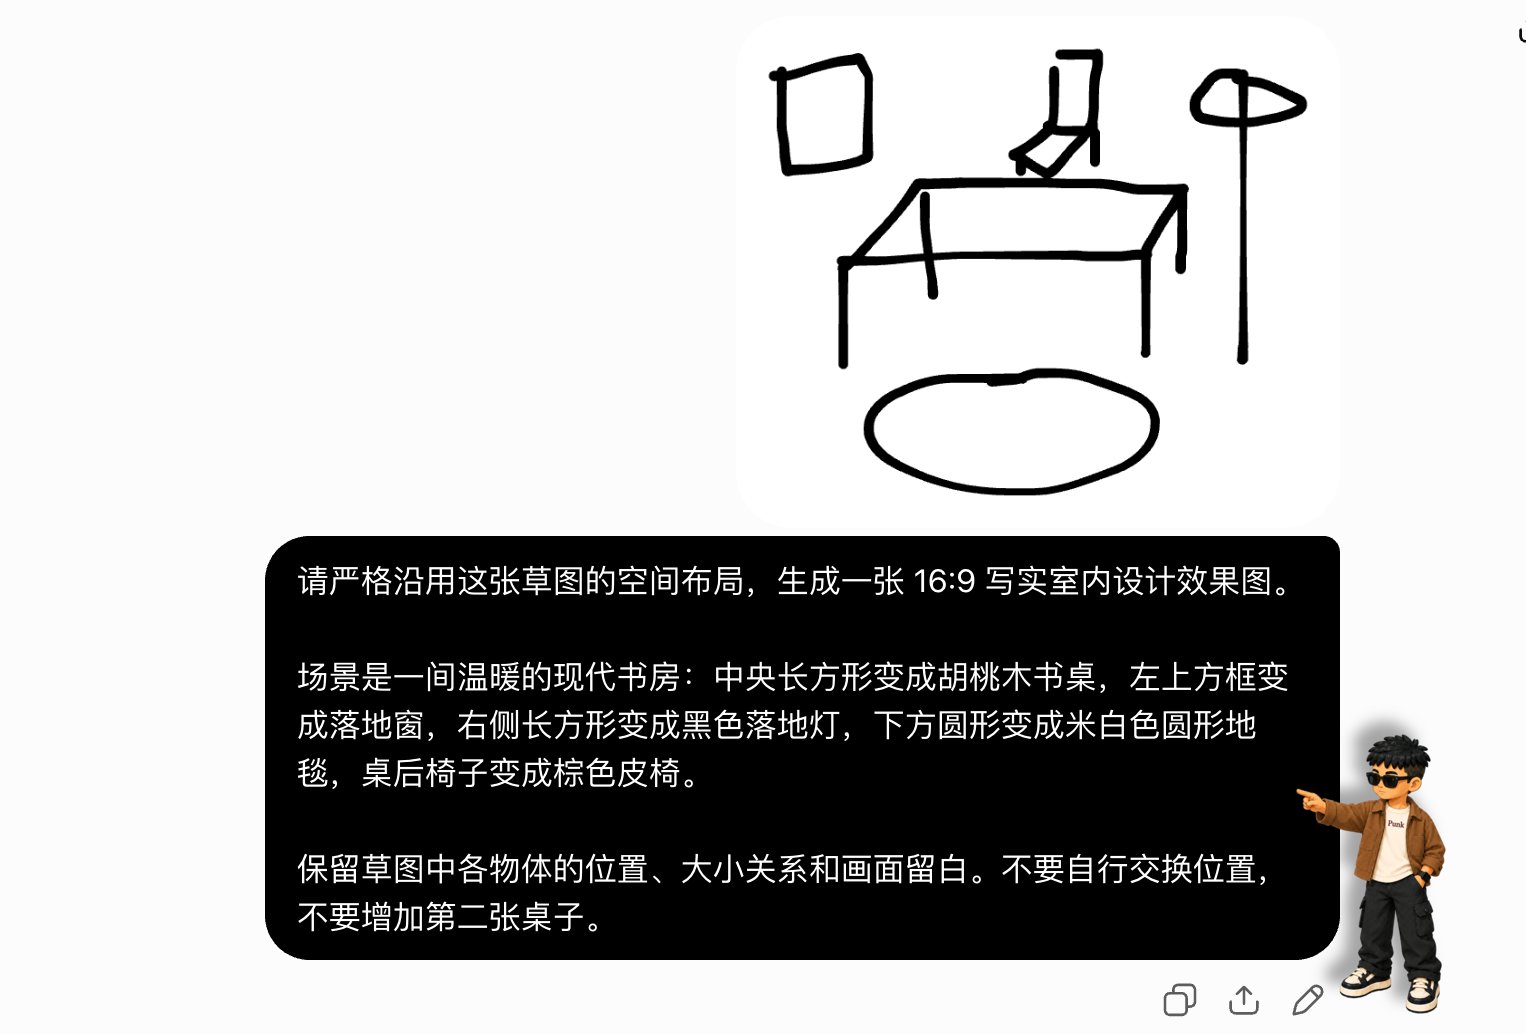
这次直接测试 2.5 新增的 Sketch 草图入口。我只画了五个很粗的形状:中央桌子、左上窗户、桌后椅子、右侧落地灯,以及下方圆形地毯,然后让它生成一张 16:9 的现代书房效果图。
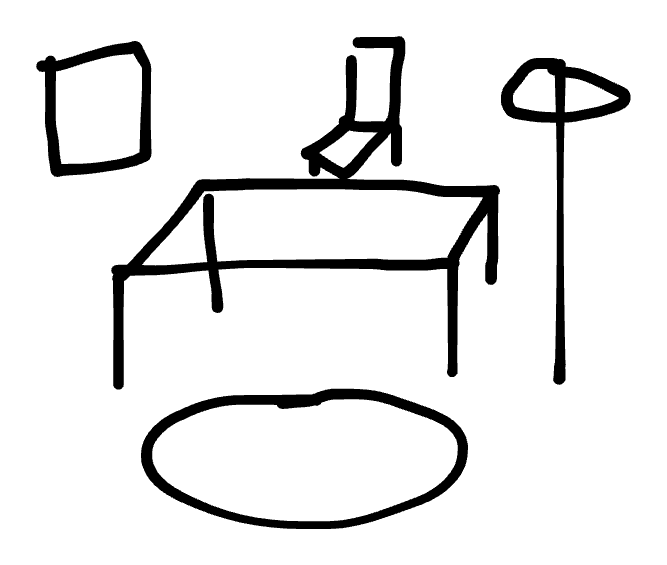
提交时,我明确要求保留每个物体的位置、大小关系和画面留白,并限制它不要交换位置、不要增加第二张桌子。下面这张截图同时保留了草图与实际输入的提示词:
生成结果如下:
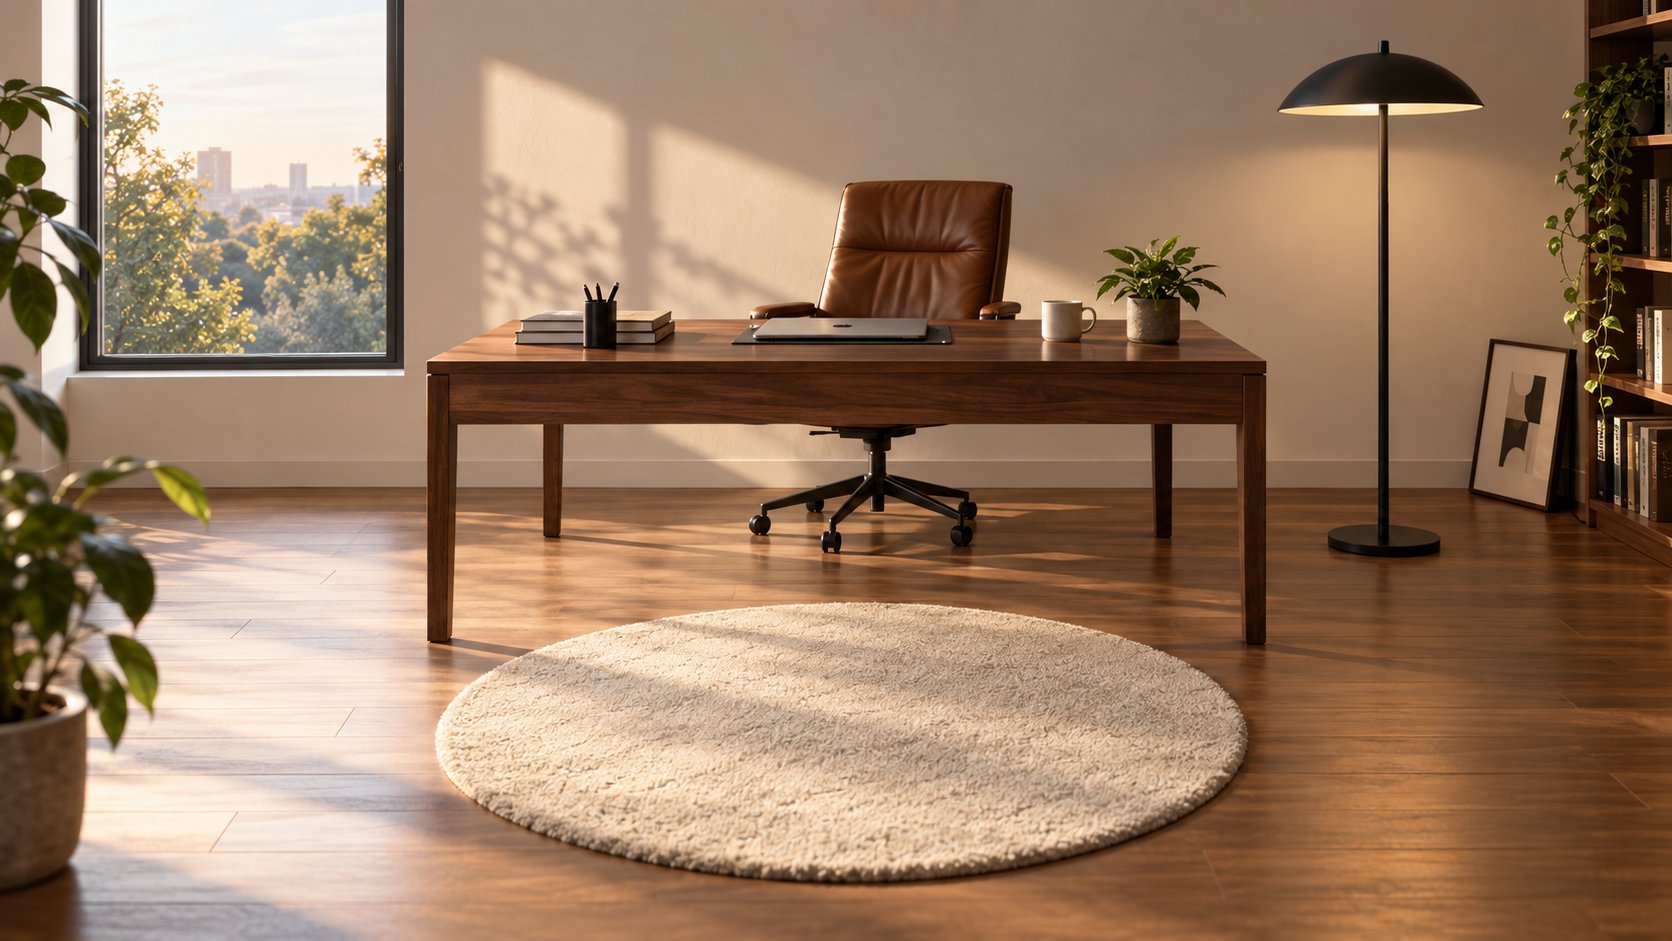
先看它做对的部分。胡桃木书桌仍在中央,棕色皮椅位于桌后,黑色落地灯在右侧,米白色圆形地毯放在下方,窗户也留在左边;成图比例是 16:9,并且没有出现第二张桌子。草图虽然画得很随意,但五个主要物体的空间关系都被识别出来了。
偏差同样明显。我要求的是「落地窗」,生成结果更接近一扇带窗台的大窗。
这组测试至少确认了一点:拿它做室内方案、海报草案和商品陈列的第一版已经有用;涉及尺寸、动线和施工准确性时,仍然要靠专业软件复核。
六、实测四:只改「92°C」里的一个数字,其他内容能不能保住
中文信息图很适合测试定点编辑。原图里有一个标题、五个流程标签、四组底部数据、四个图标和四个箭头,任何一处乱码、漏字或错位都能直接看出来。
生成原图时实际提交的提示词:
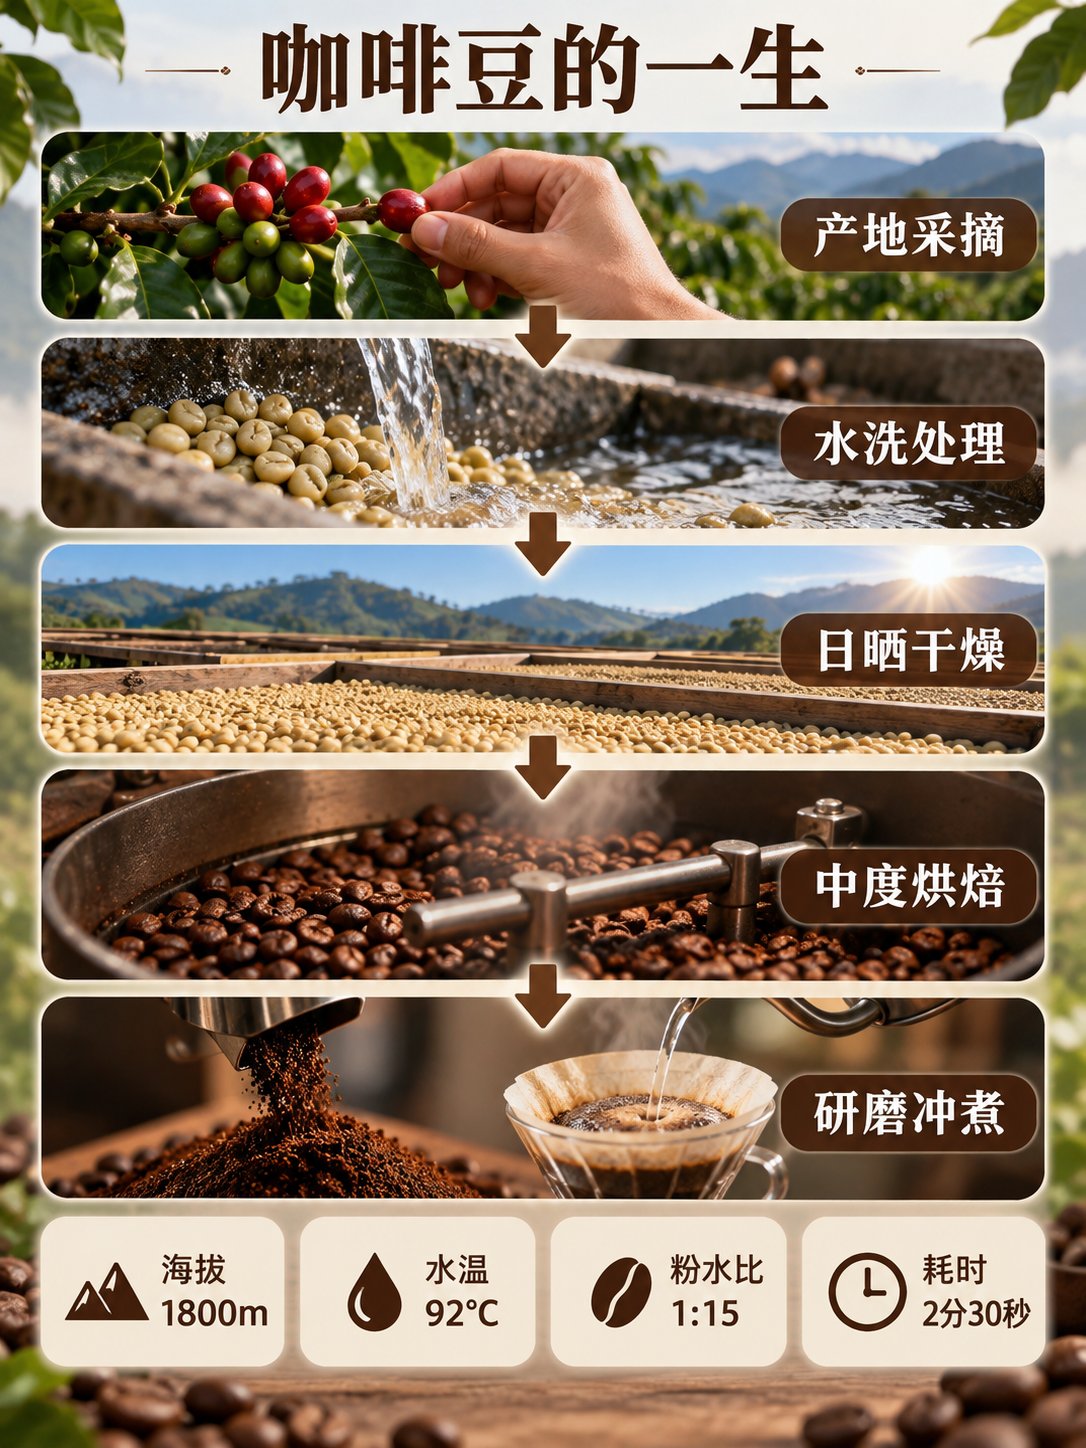
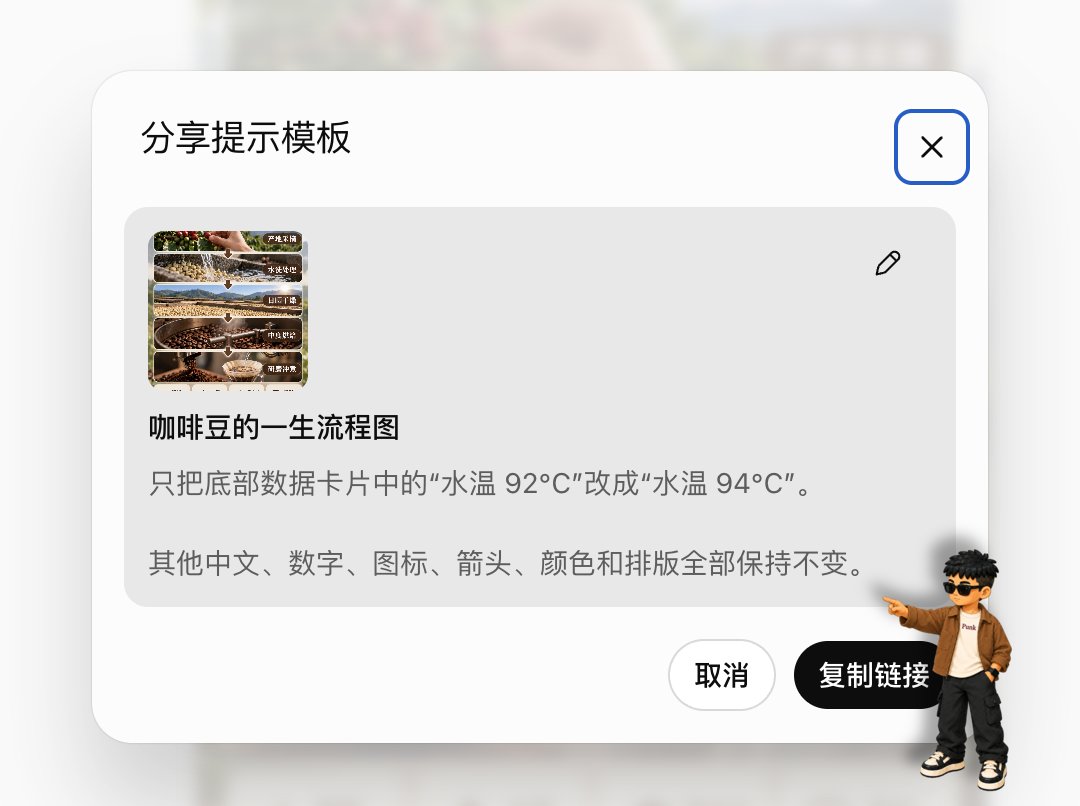
这轮指令只改一处:把底部数据卡片中的「水温 92°C」改成「水温 94°C」,其余中文、数字、图标、箭头、颜色和排版全部保持不变。下面是实际提交与修改完成后的界面:
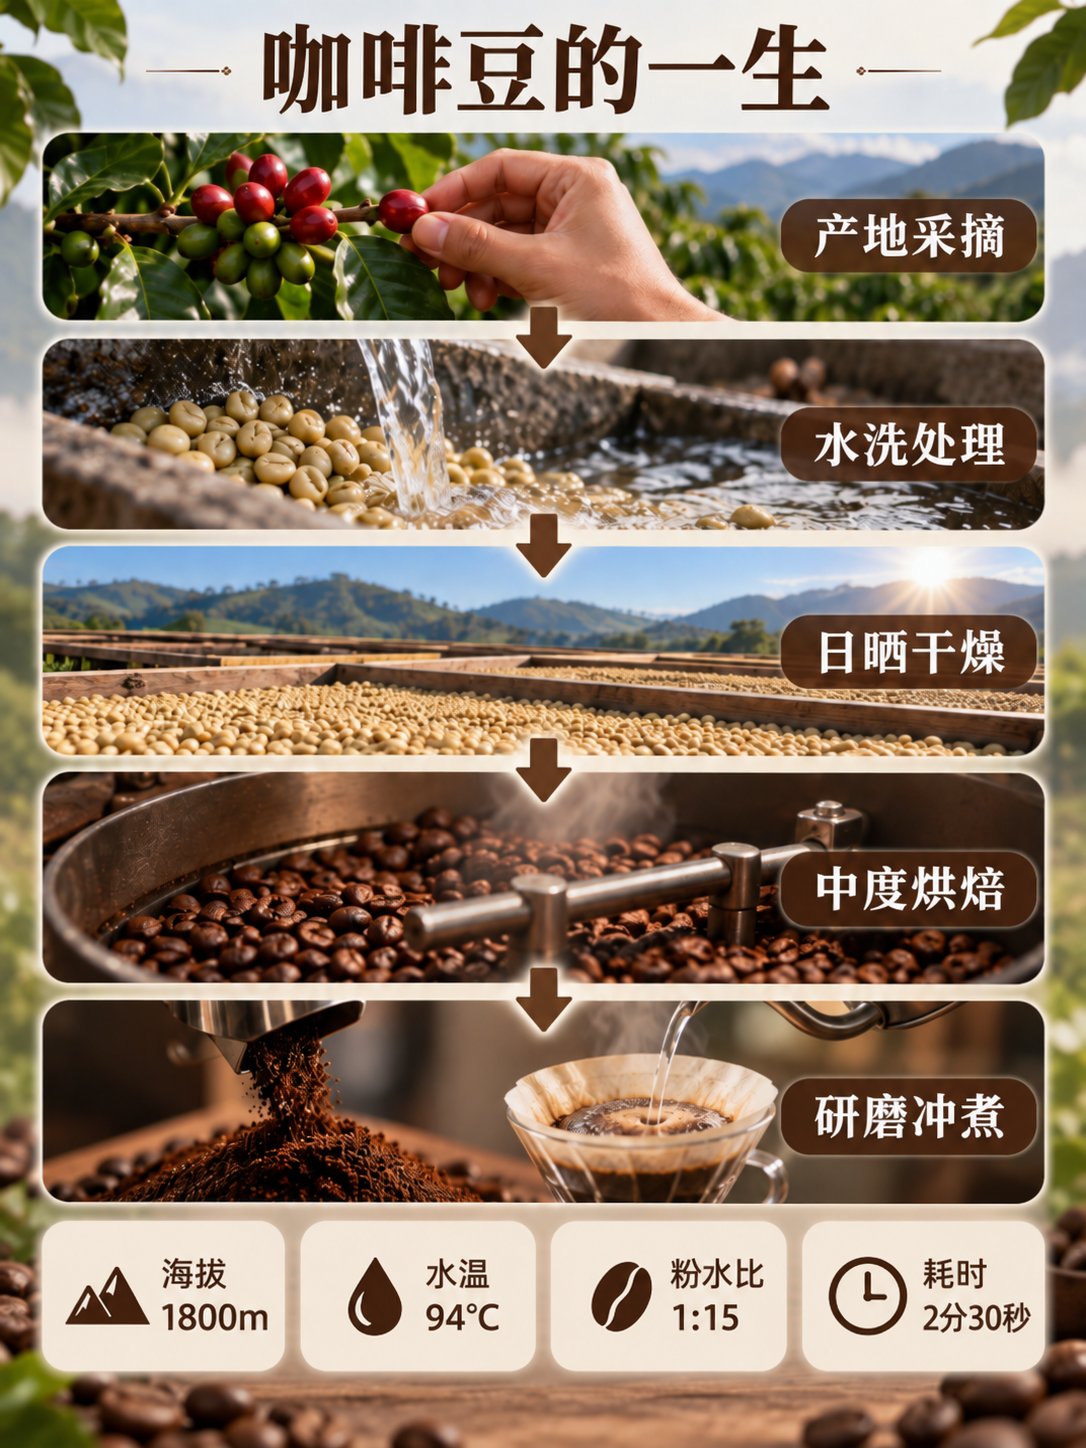
目标数字改对了,「92°C」准确变成「94°C」。标题「咖啡豆的一生」、五个流程标签,以及海拔、粉水比和耗时三组数据均未出现乱码或漏字;五段流程、箭头和底部卡片的位置也保持一致。
把两张图放大对比,未修改区域仍然发生了重绘。咖啡豆的数量和形状、水花、手部、烘焙设备、背景细节以及部分图标轮廓都有变化,只是整体构图、色调和信息层级看上去接近。它保住了文字内容与版式关系,没有做到只替换「2」这个字符的像素。
如果你做的是社媒信息图、方案草稿或普通内容配图,这种稳定程度已经能用。印刷物、品牌模板和需要精确复用底图的设计稿,改完仍要逐项核对,严格改单字最好继续交给 Photoshop、Figma 这类工具。
七、实测五:Poster 模板,会先帮你把需求问清楚
最后测试模板。我进入 ChatGPT 的图片页面,当前能看到 Poster、Interior design、Logo、Illustration、Headshot、Icon、Product photo 和 Merch 等模版入口,这次选择的是第一个 Poster。
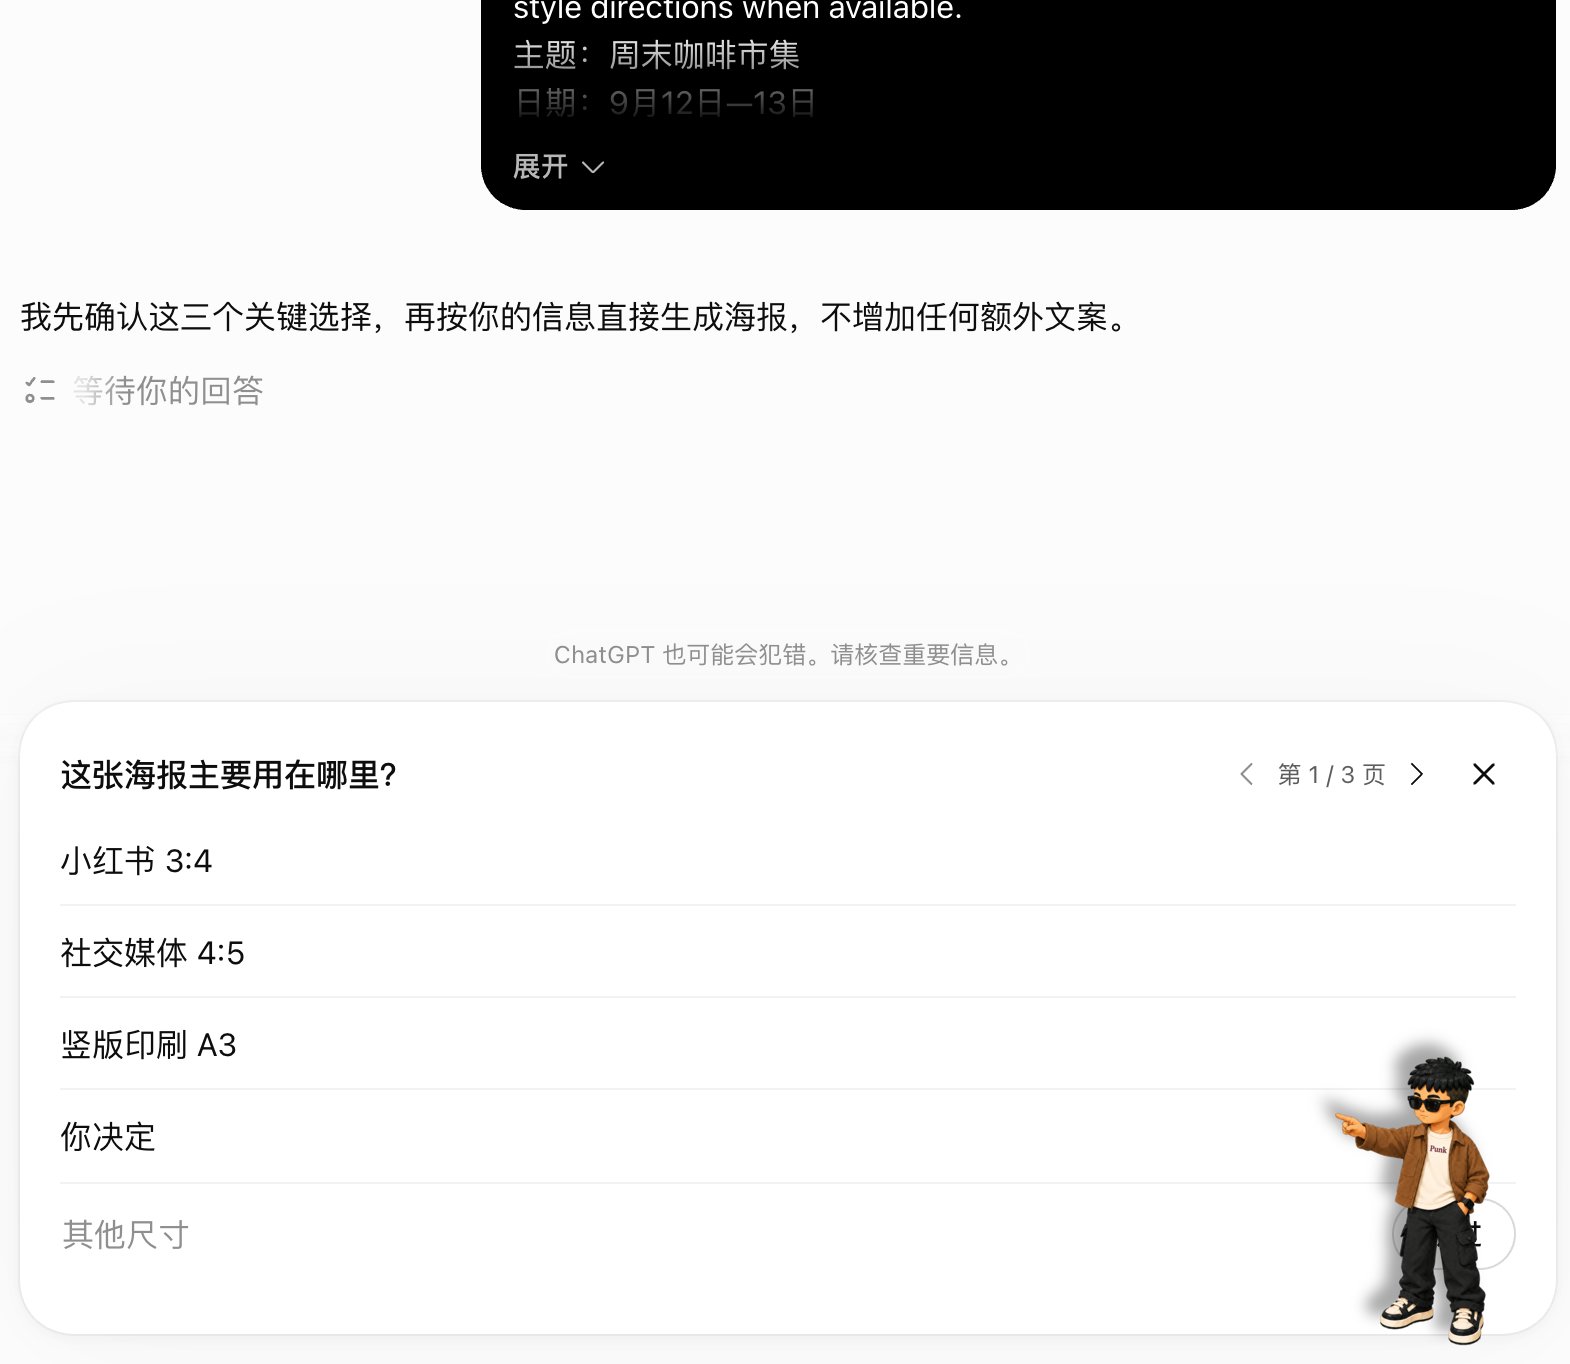
实际输入的内容:
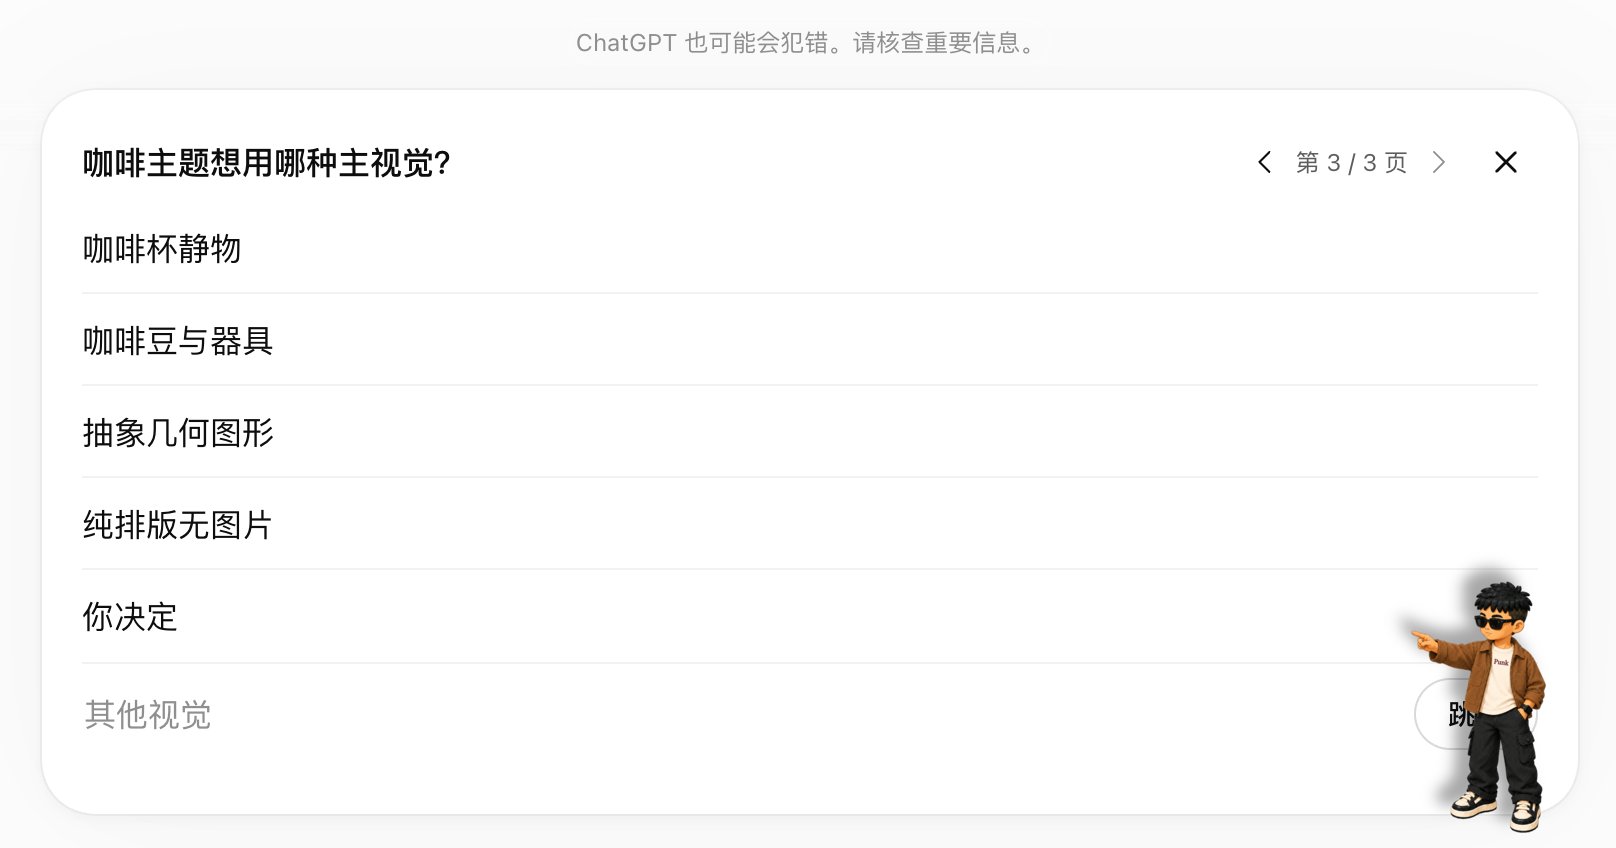
选中 Poster 后,它没有立刻开始生图,而是连续问了三页问题。第一页确认用途和尺寸,给出小红书 3:4、社交媒体 4:5、竖版印刷 A3 等选项;第二页让你从五种构图中选择;第三页再确认咖啡主题的主视觉。
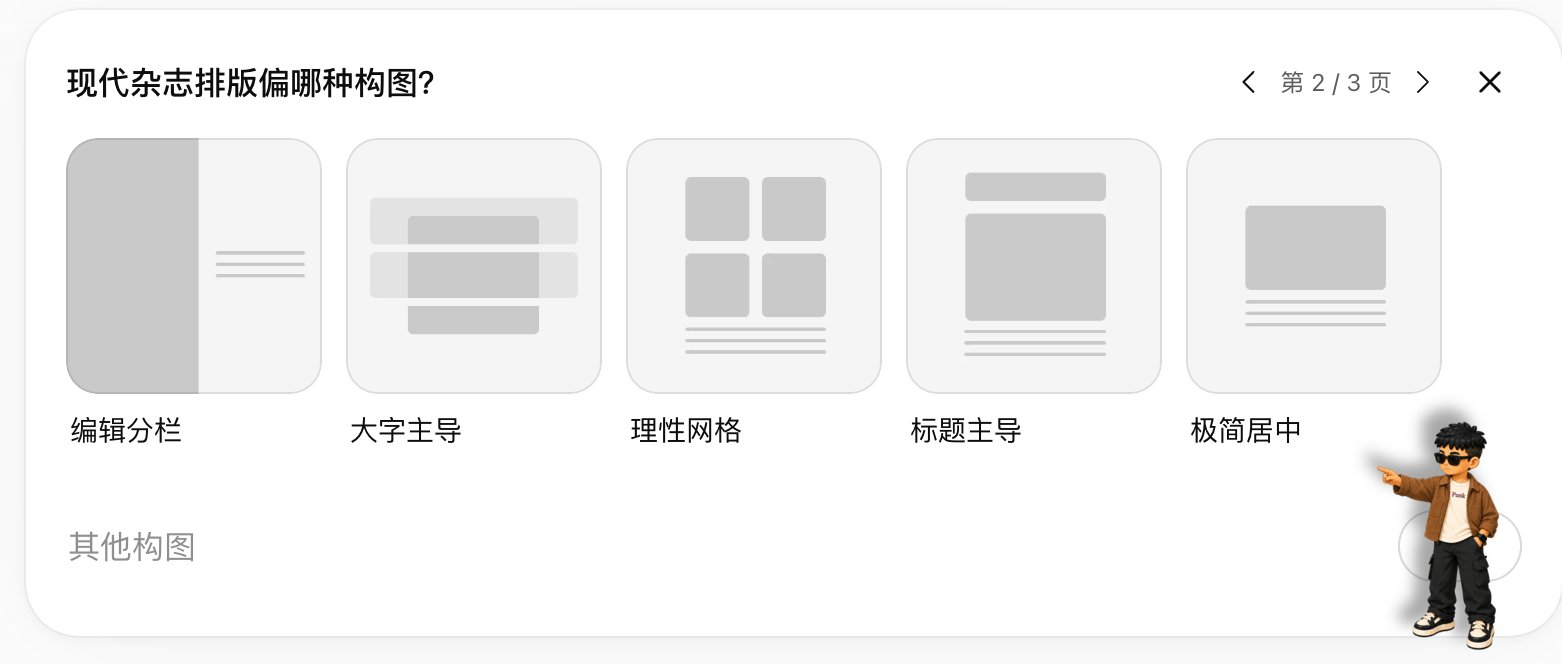
除了尺寸、构图和主视觉,Poster 里还会给出常用的整体视觉方向。当前页面能看到现代编辑设计、大胆图形海报、极简高级、扁平几何和科技渐变等预设,也可以横向继续浏览、填写其他视觉参考或直接跳过。
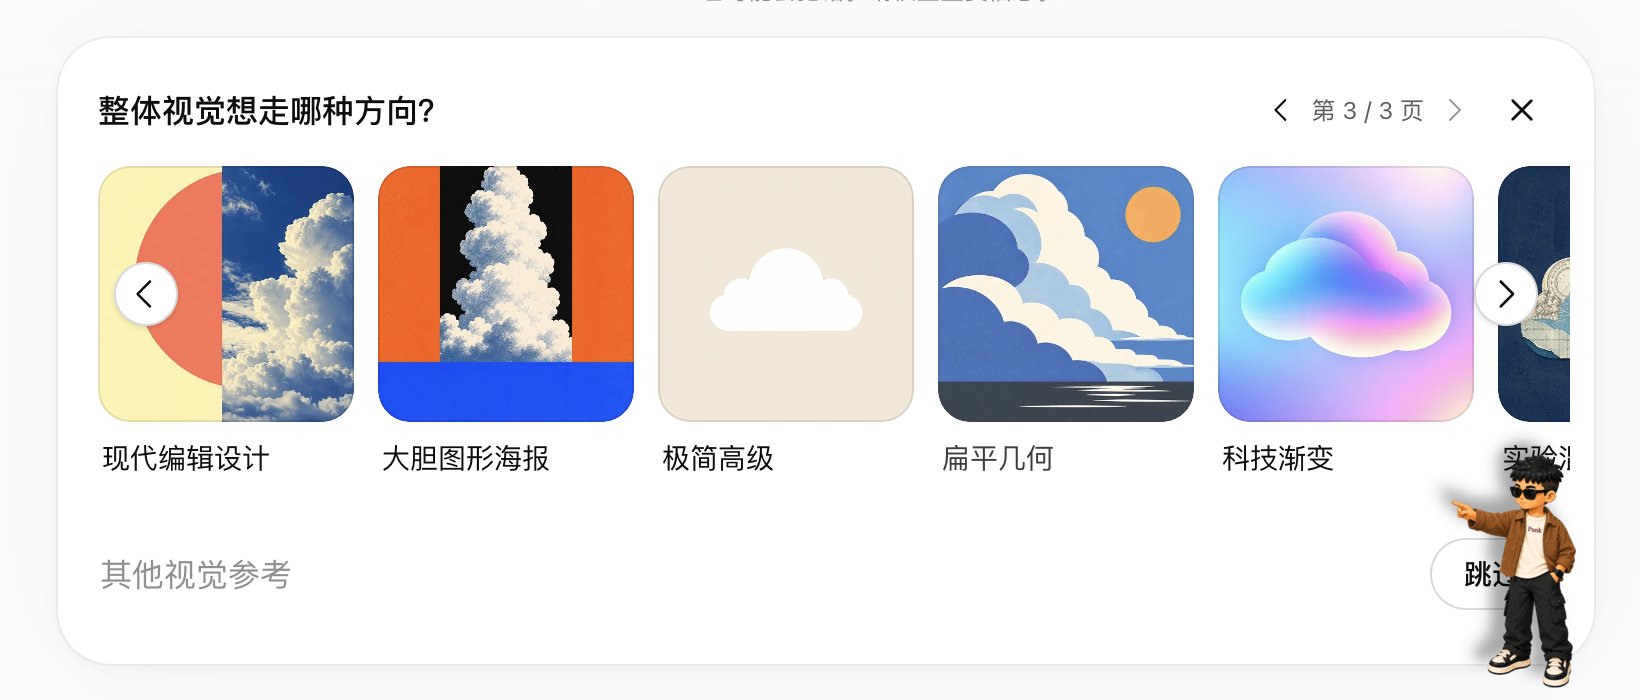
这个流程对不熟悉提示词的人很友好。尺寸、构图、主视觉和设计风格原本最容易漏写,模板把它们拆成可点击的选项,还允许跳过、交给模型决定或填写其他答案。
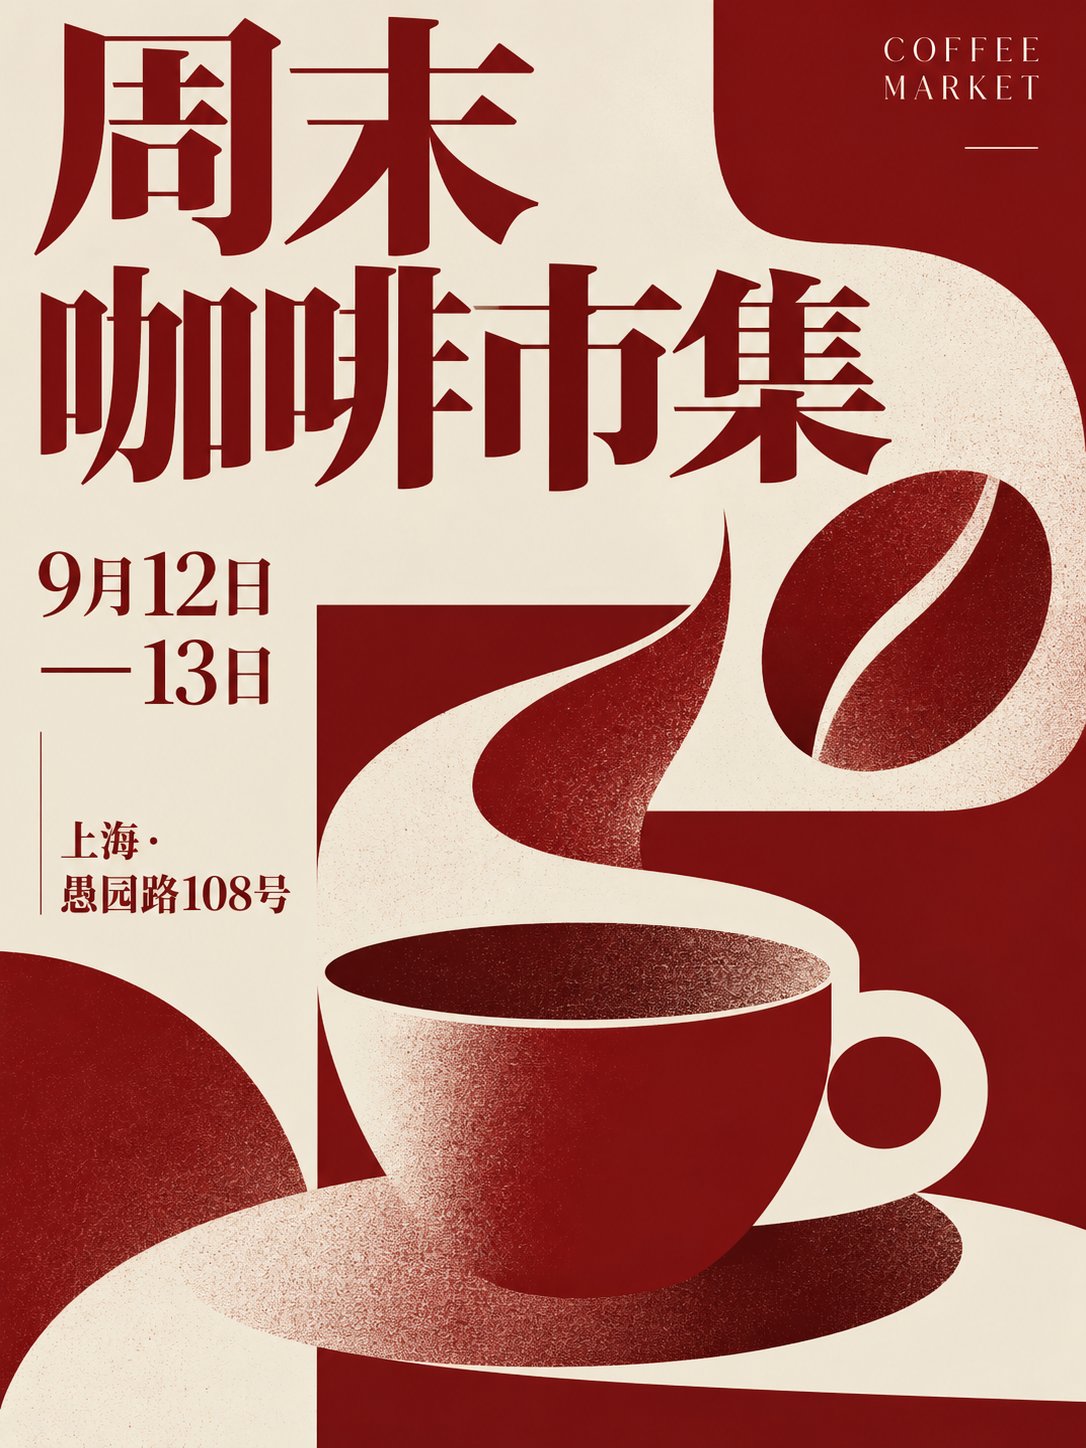
最终生成的是一张红色与米白色搭配的 3:4 海报。主标题「周末咖啡市集」、日期「9月12日—13日」和地址「上海·愚园路108号」都准确,字号层级清楚,咖啡杯、咖啡豆和蒸汽图形也形成了完整视觉。
官方文档提到的Prompt分享,藏在编辑页面里。先从图片卡片左下角点「编辑」,再点编辑页右上角的「分享」,展开菜单后选择第二项「分享提示模板」:
随后会弹出「分享提示模板」窗口,里面保留图片缩略图、模板标题和完整修改指令;还可以点铅笔继续编辑,最后复制链接:
八、结论
如果只看发布表,GPT-Image 2.5 像一次常规的「更快、更清晰、更听话」。亲手连续改图后,我感受到的差距集中在一个动作:你终于可以围绕一张还不错的第一版继续工作,不用每说一句都重新抽盲盒。
复杂物件关系、四轮连续修改、草图转写实图、中文信息图改单字、透明 PNG 导出和 Poster 模板,这次都给出了可用结果。草图能控制主要物体的位置,但会主动补充场景细节;信息图可以保住文字与版式关系,未指定区域仍会重新绘制;透明通道和边缘检查均通过;Poster 模板把尺寸、构图、主视觉和常用设计风格都做成了可选项,成片完成度很高。
对普通 ChatGPT 用户,当前可以确认的是 Images 2.5 已经能跑通连续编辑、草图控构图、信息图改单字、透明 PNG 导出和模板化出图。
关于作者
Punk|中科大管理学硕士|AI提示词、AI小白教程|Punk系列Skills作者|3个月赚了8位数|Learn in Public|FDE文章浏览量240w|@AdrianPunk115
最后更新于 2026-09-26 10:15:30 并被添加「Twitter」标签,已有 8 位童鞋阅读过。
本站使用「署名 4.0 国际」创作共享协议,可自由转载、引用,但需署名作者且注明文章出处
此处评论已关闭