本地部署Qwen-Image-2.1
所有有 GPU 或者 Macbook 的朋友,都应该本地部署一次 Qwen-Image-2.1(写实) 和 Anima(二次元)!不联网、无审查,小显存、小统一内存也能跑。
我测试了一周,感觉的十分惊艳,下面整理了一批本地能跑的出图模型。友情提示:
Qwen 擅长写实、构图、图里写字,需要二次元就换 Anima。
一、写实主力:Qwen-Image-2.1
Mac 首选 MLX 4bit(mflux 跑):https://huggingface.co/JoyFusionAI/Qwen-Image-2.1-MLX-4bit
GGUF Q4_K(stable-diffusion.cpp 跑):https://huggingface.co/leejet/Qwen-Image-2.1-GGUF
文本编码器:https://huggingface.co/Qwen/Qwen3-VL-8B-Instruct-GGUF
专属 VAE(别换成别的):https://huggingface.co/Comfy-Org/Qwen-Image-2.1
两个坑:cfg 用 1,这个模型按无引导训练,开到 6 慢一倍、画质没提升;mflux 跑 20 步构图容易崩,正式出图用 40 步。
二、二次元主力:Anima
基于 NVIDIA Cosmos-Predict2 的新架构,约 2B,不是 SDXL 微调。Danbooru 标签和自然语言都能用,比 Qwen 轻得多。
官方:https://huggingface.co/circlestone-labs/Anima
Civitai:https://civitai.com/models/2458426/anima
WAI 作者的版本 WAI-Anima:https://civitai.com/models/2544636/wai-anima
WAI-Anima int8 量化(约 2.1GB,省显存):https://civitai.com/models/2758727/wai-anima-int8-mxfp8
有三个版本:Base 适合练 LoRA,Aesthetic 默认画风更好看,Turbo 8–12 步出图。要单独配文本编码器 qwen_3_06b 和 Qwen-Image VAE,不是普通的 checkpoint,丢进去不能直接跑。
三、要锁定角色、要海量 LoRA:Illustrious 系列
WAI-Illustrious SDXL:https://civitai.com/models/827184
角色一致性和服装标签,LoRA 数量约 20 万级,冷门角色基本都有。
最后值得注意:模型文件本身也可能被投毒。只下 .safetensors,不碰 .ckpt / .pt;Civitai 上来源不明的 merge 慎用,注意核查hash。Anima 系列是非商用许可,商用前需要注意这点。
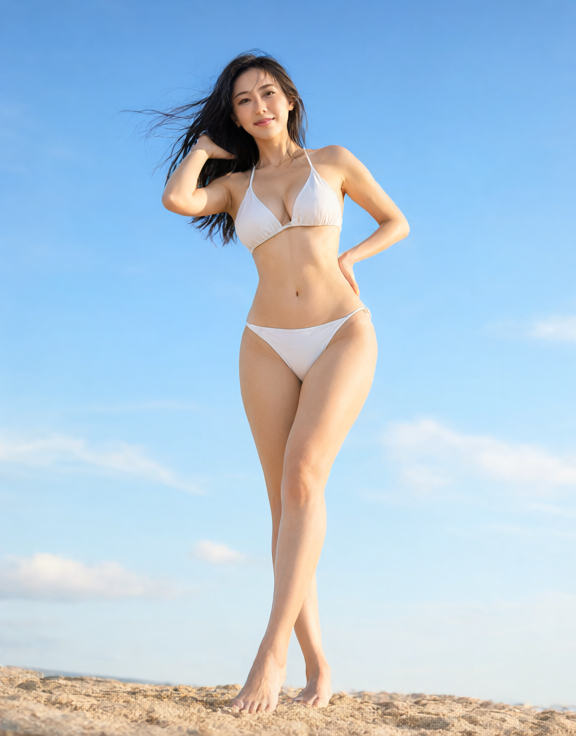
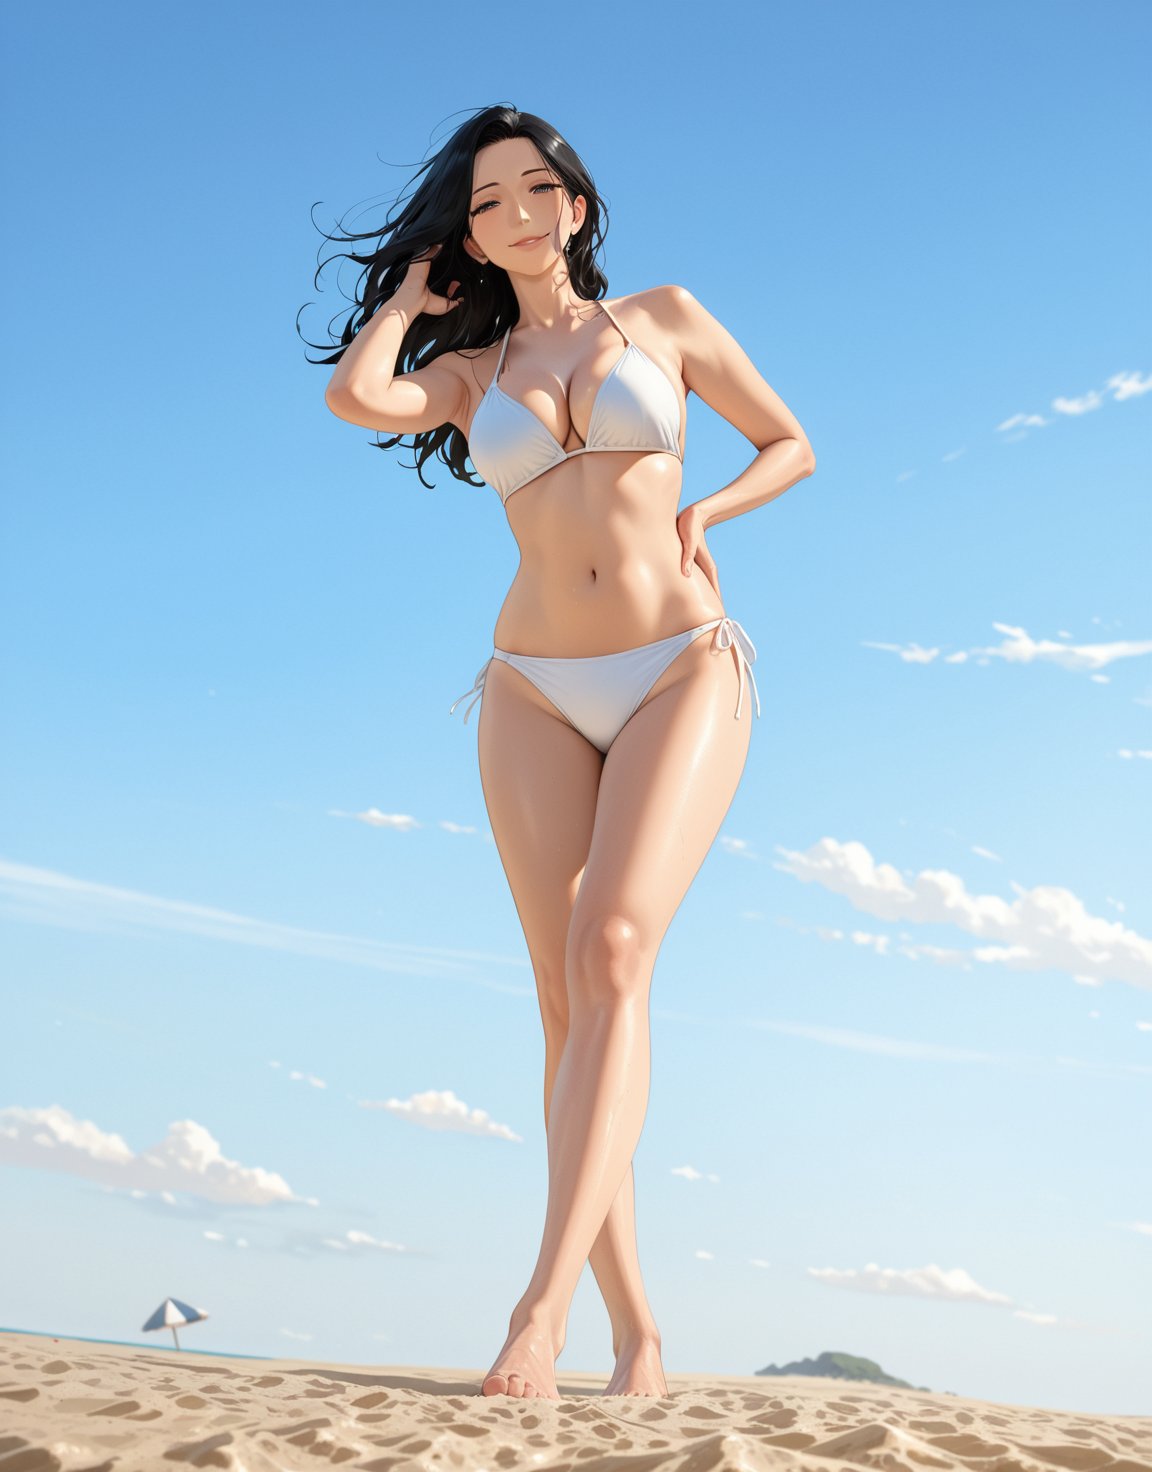
效果直出👇
有一个模型比 Qwen-Image-2.1 更牛,可能 90% 玩本地大模型的朋友都不知道。论 NSFW……人家可是老祖宗,更关键的是,生成速度是 Qwen 的 5 倍!!!
这么说吧,我在 Mac 上跑了上百张实测,Qwen-Image-2.1 出一张最高分辨率(1328×1328)的图要 30 分钟,这个模型出一张只要 5 分钟😆
它就是 x.com/wquguru/status…
我测试了一周,感觉的十分惊艳,下面整理了一批本地能跑的出图模型。友情提示:
Qwen 擅长写实、构图、图里写字,需要二次元就换 Anima。
一、写实主力:Qwen-Image-2.1
Mac 首选 MLX 4bit(mflux 跑):https://huggingface.co/JoyFusionAI/Qwen-Image-2.1-MLX-4bit
GGUF Q4_K(stable-diffusion.cpp 跑):https://huggingface.co/leejet/Qwen-Image-2.1-GGUF
文本编码器:https://huggingface.co/Qwen/Qwen3-VL-8B-Instruct-GGUF
专属 VAE(别换成别的):https://huggingface.co/Comfy-Org/Qwen-Image-2.1
两个坑:cfg 用 1,这个模型按无引导训练,开到 6 慢一倍、画质没提升;mflux 跑 20 步构图容易崩,正式出图用 40 步。
二、二次元主力:Anima
基于 NVIDIA Cosmos-Predict2 的新架构,约 2B,不是 SDXL 微调。Danbooru 标签和自然语言都能用,比 Qwen 轻得多。
官方:https://huggingface.co/circlestone-labs/Anima
Civitai:https://civitai.com/models/2458426/anima
WAI 作者的版本 WAI-Anima:https://civitai.com/models/2544636/wai-anima
WAI-Anima int8 量化(约 2.1GB,省显存):https://civitai.com/models/2758727/wai-anima-int8-mxfp8
有三个版本:Base 适合练 LoRA,Aesthetic 默认画风更好看,Turbo 8–12 步出图。要单独配文本编码器 qwen_3_06b 和 Qwen-Image VAE,不是普通的 checkpoint,丢进去不能直接跑。
三、要锁定角色、要海量 LoRA:Illustrious 系列
WAI-Illustrious SDXL:https://civitai.com/models/827184
角色一致性和服装标签,LoRA 数量约 20 万级,冷门角色基本都有。
最后值得注意:模型文件本身也可能被投毒。只下 .safetensors,不碰 .ckpt / .pt;Civitai 上来源不明的 merge 慎用,注意核查hash。Anima 系列是非商用许可,商用前需要注意这点。
效果直出👇
有一个模型比 Qwen-Image-2.1 更牛,可能 90% 玩本地大模型的朋友都不知道。论 NSFW……人家可是老祖宗,更关键的是,生成速度是 Qwen 的 5 倍!!!
这么说吧,我在 Mac 上跑了上百张实测,Qwen-Image-2.1 出一张最高分辨率(1328×1328)的图要 30 分钟,这个模型出一张只要 5 分钟😆
它就是 x.com/wquguru/status…
此处感谢 @Ensufall 关于二次元模型的科普
我有一个主意,让本地无审查模型生成分镜,然后丢给视频模型,各自发挥下想象力...
先跑它1000套NSFW图试试
NVIDIA显卡会快很多,Mac比较拉胯
最后更新于 2026-09-26 09:18:36 并被添加「Twitter」标签,已有 14 位童鞋阅读过。
本站使用「署名 4.0 国际」创作共享协议,可自由转载、引用,但需署名作者且注明文章出处
此处评论已关闭